
Todos os dados pessoais do exemplo são fictícios: CPF, CNPJ e cartão de teste.
Toda empresa que começou a usar IA passou pela mesma cena. Alguém do suporte copia um chamado, cola no chat e pede um resumo. O resumo chega em dez segundos, bem escrito. Junto com a pergunta, saíram da empresa o nome da cliente, o CPF, o número do cartão, o endereço e, no meio do texto, uma informação de saúde.
Ninguém fez isso por descuido. Fez porque funciona e porque ninguém entregou um jeito melhor. Este tutorial é esse jeito: um pipeline pequeno, em TypeScript, que tira os dados pessoais do texto antes de ele chegar à IA e devolve os dados no lugar certo depois que a resposta volta. Usamos o Claude em duas frentes: pela API, como detector de dado pessoal que regex não pega, e pelo Claude Code, para escrever e testar o próprio anonimizador sem nunca encostar em dado real.
O que vai junto quando alguém cola um chamado na IA
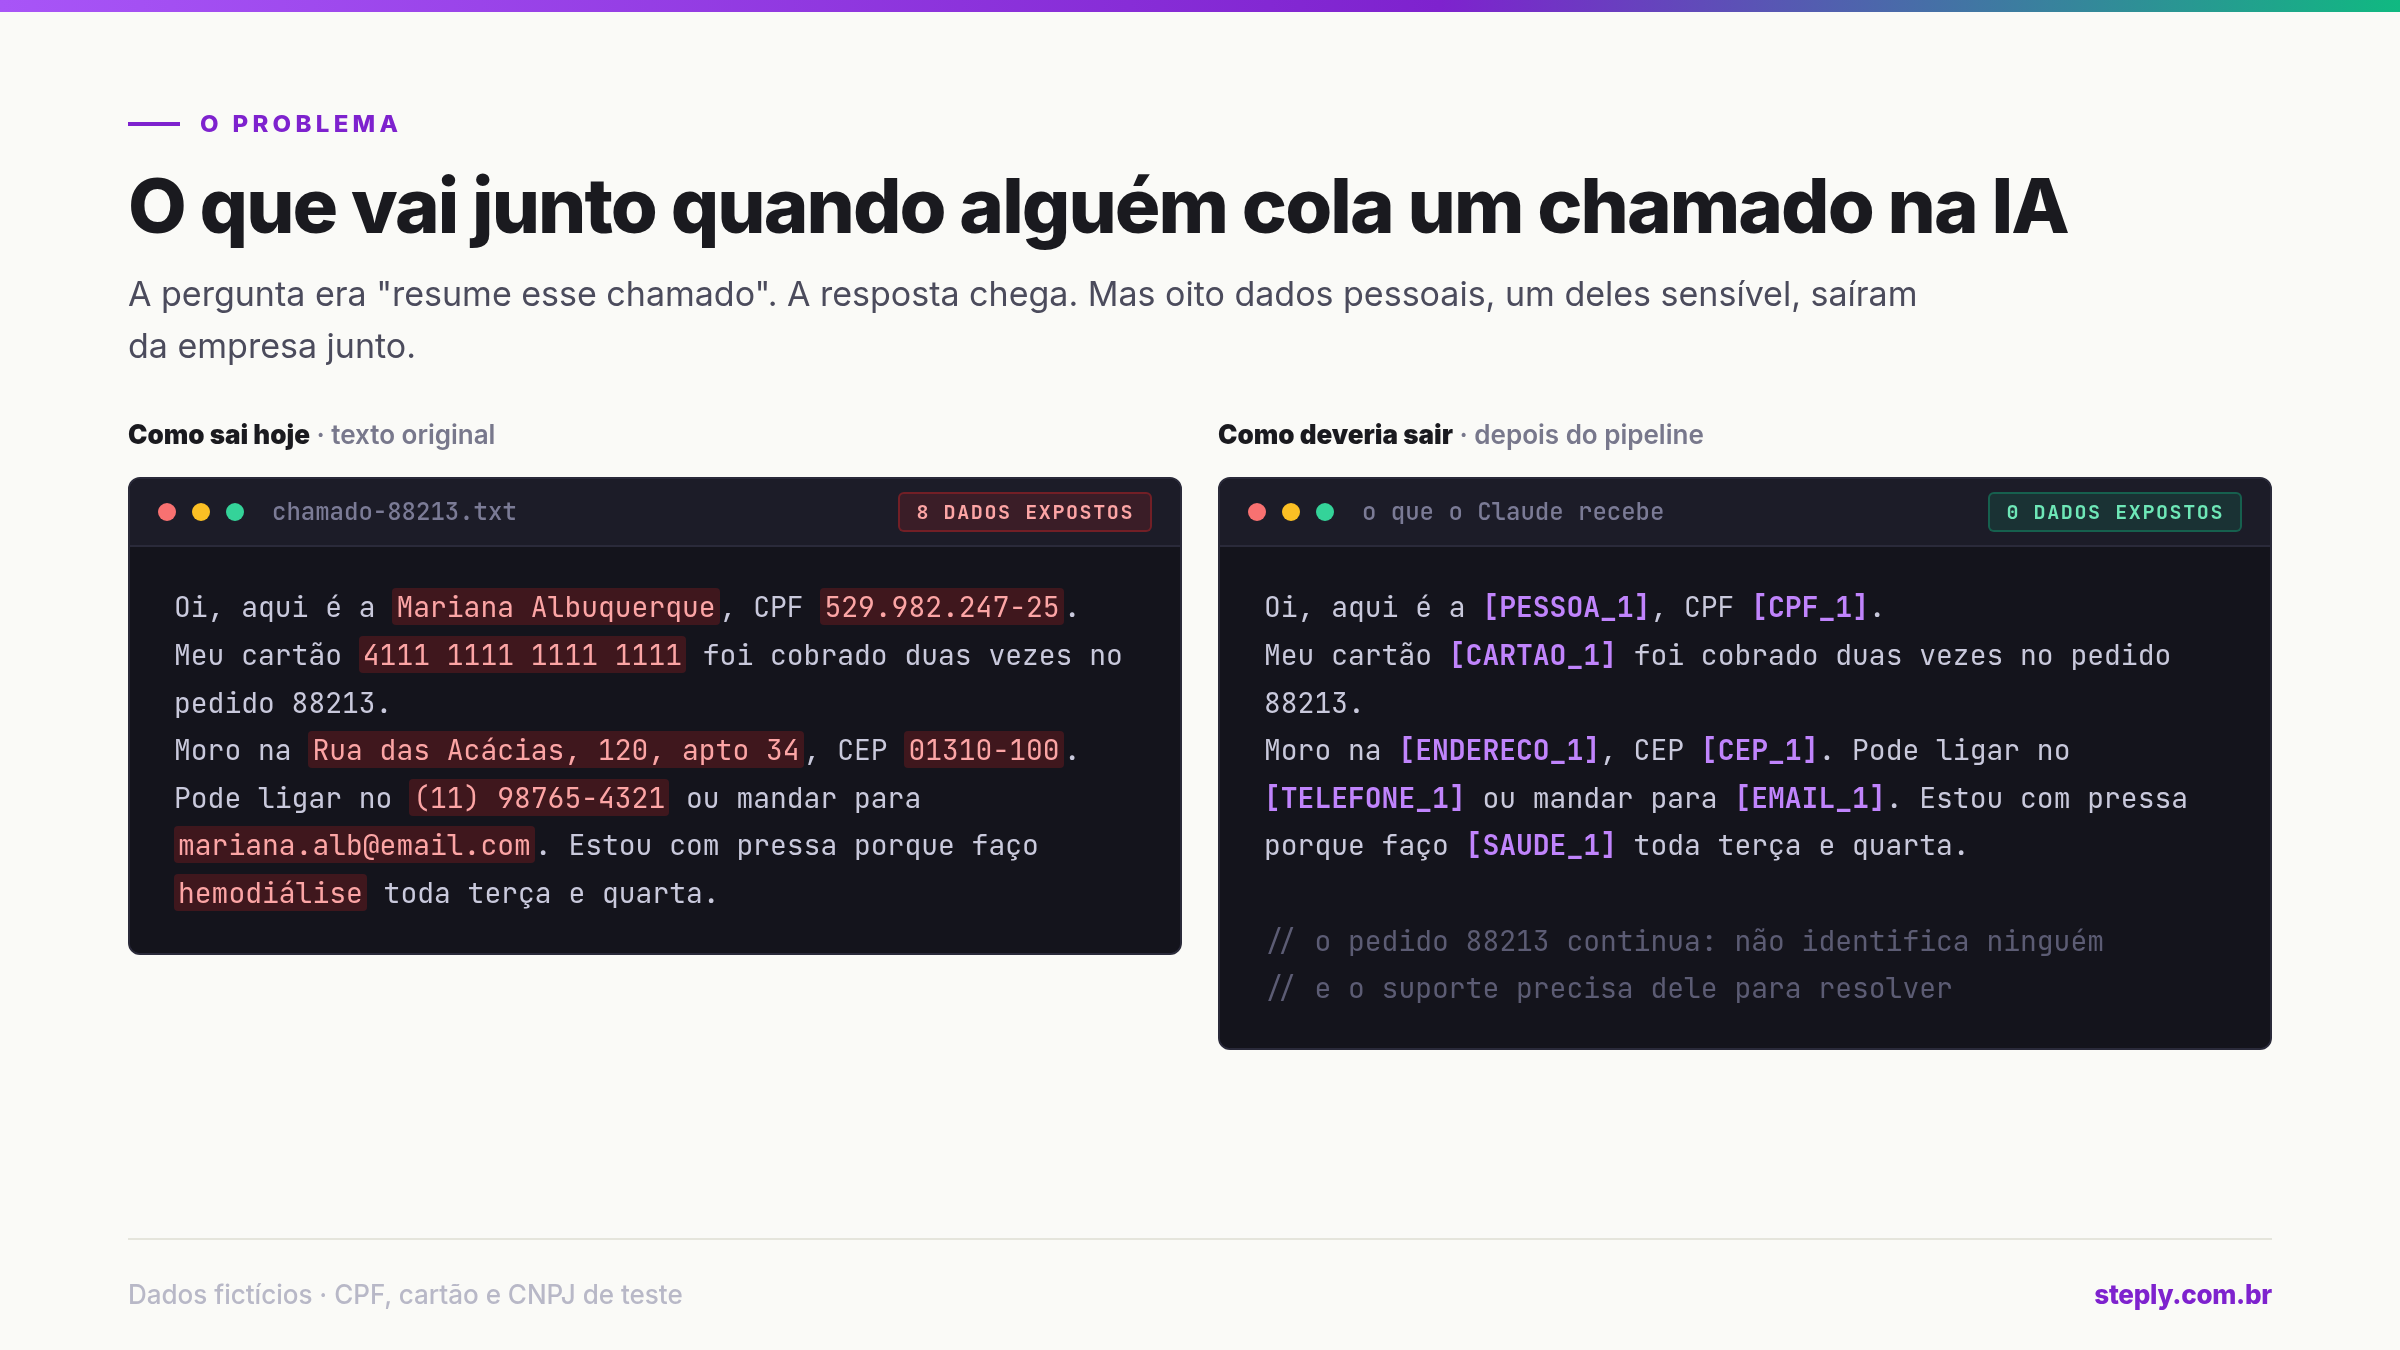
Este é o chamado que vamos usar do começo ao fim:
Oi, aqui é a Mariana Albuquerque, CPF 529.982.247-25.
Meu cartão 4111 1111 1111 1111 foi cobrado duas vezes no pedido 88213.
Moro na Rua das Acácias, 120, apto 34, CEP 01310-100. Pode ligar no (11) 98765-4321
ou mandar para mariana.alb@email.com. Estou com pressa porque faço hemodiálise
toda terça e quarta. A empresa é a Albuquerque Doces, CNPJ 11.222.333/0001-81.
São oito dados que identificam uma pessoa, e um deles, a hemodiálise, é dado sensível pela LGPD. Repare no que não é dado pessoal: o número do pedido. Ele não aponta para ninguém sozinho, e o suporte precisa dele para resolver o problema. Anonimizar bem não é apagar tudo que tem número. É tirar o que identifica e manter o que dá contexto.
Antes do código: anonimizar não é pseudonimizar
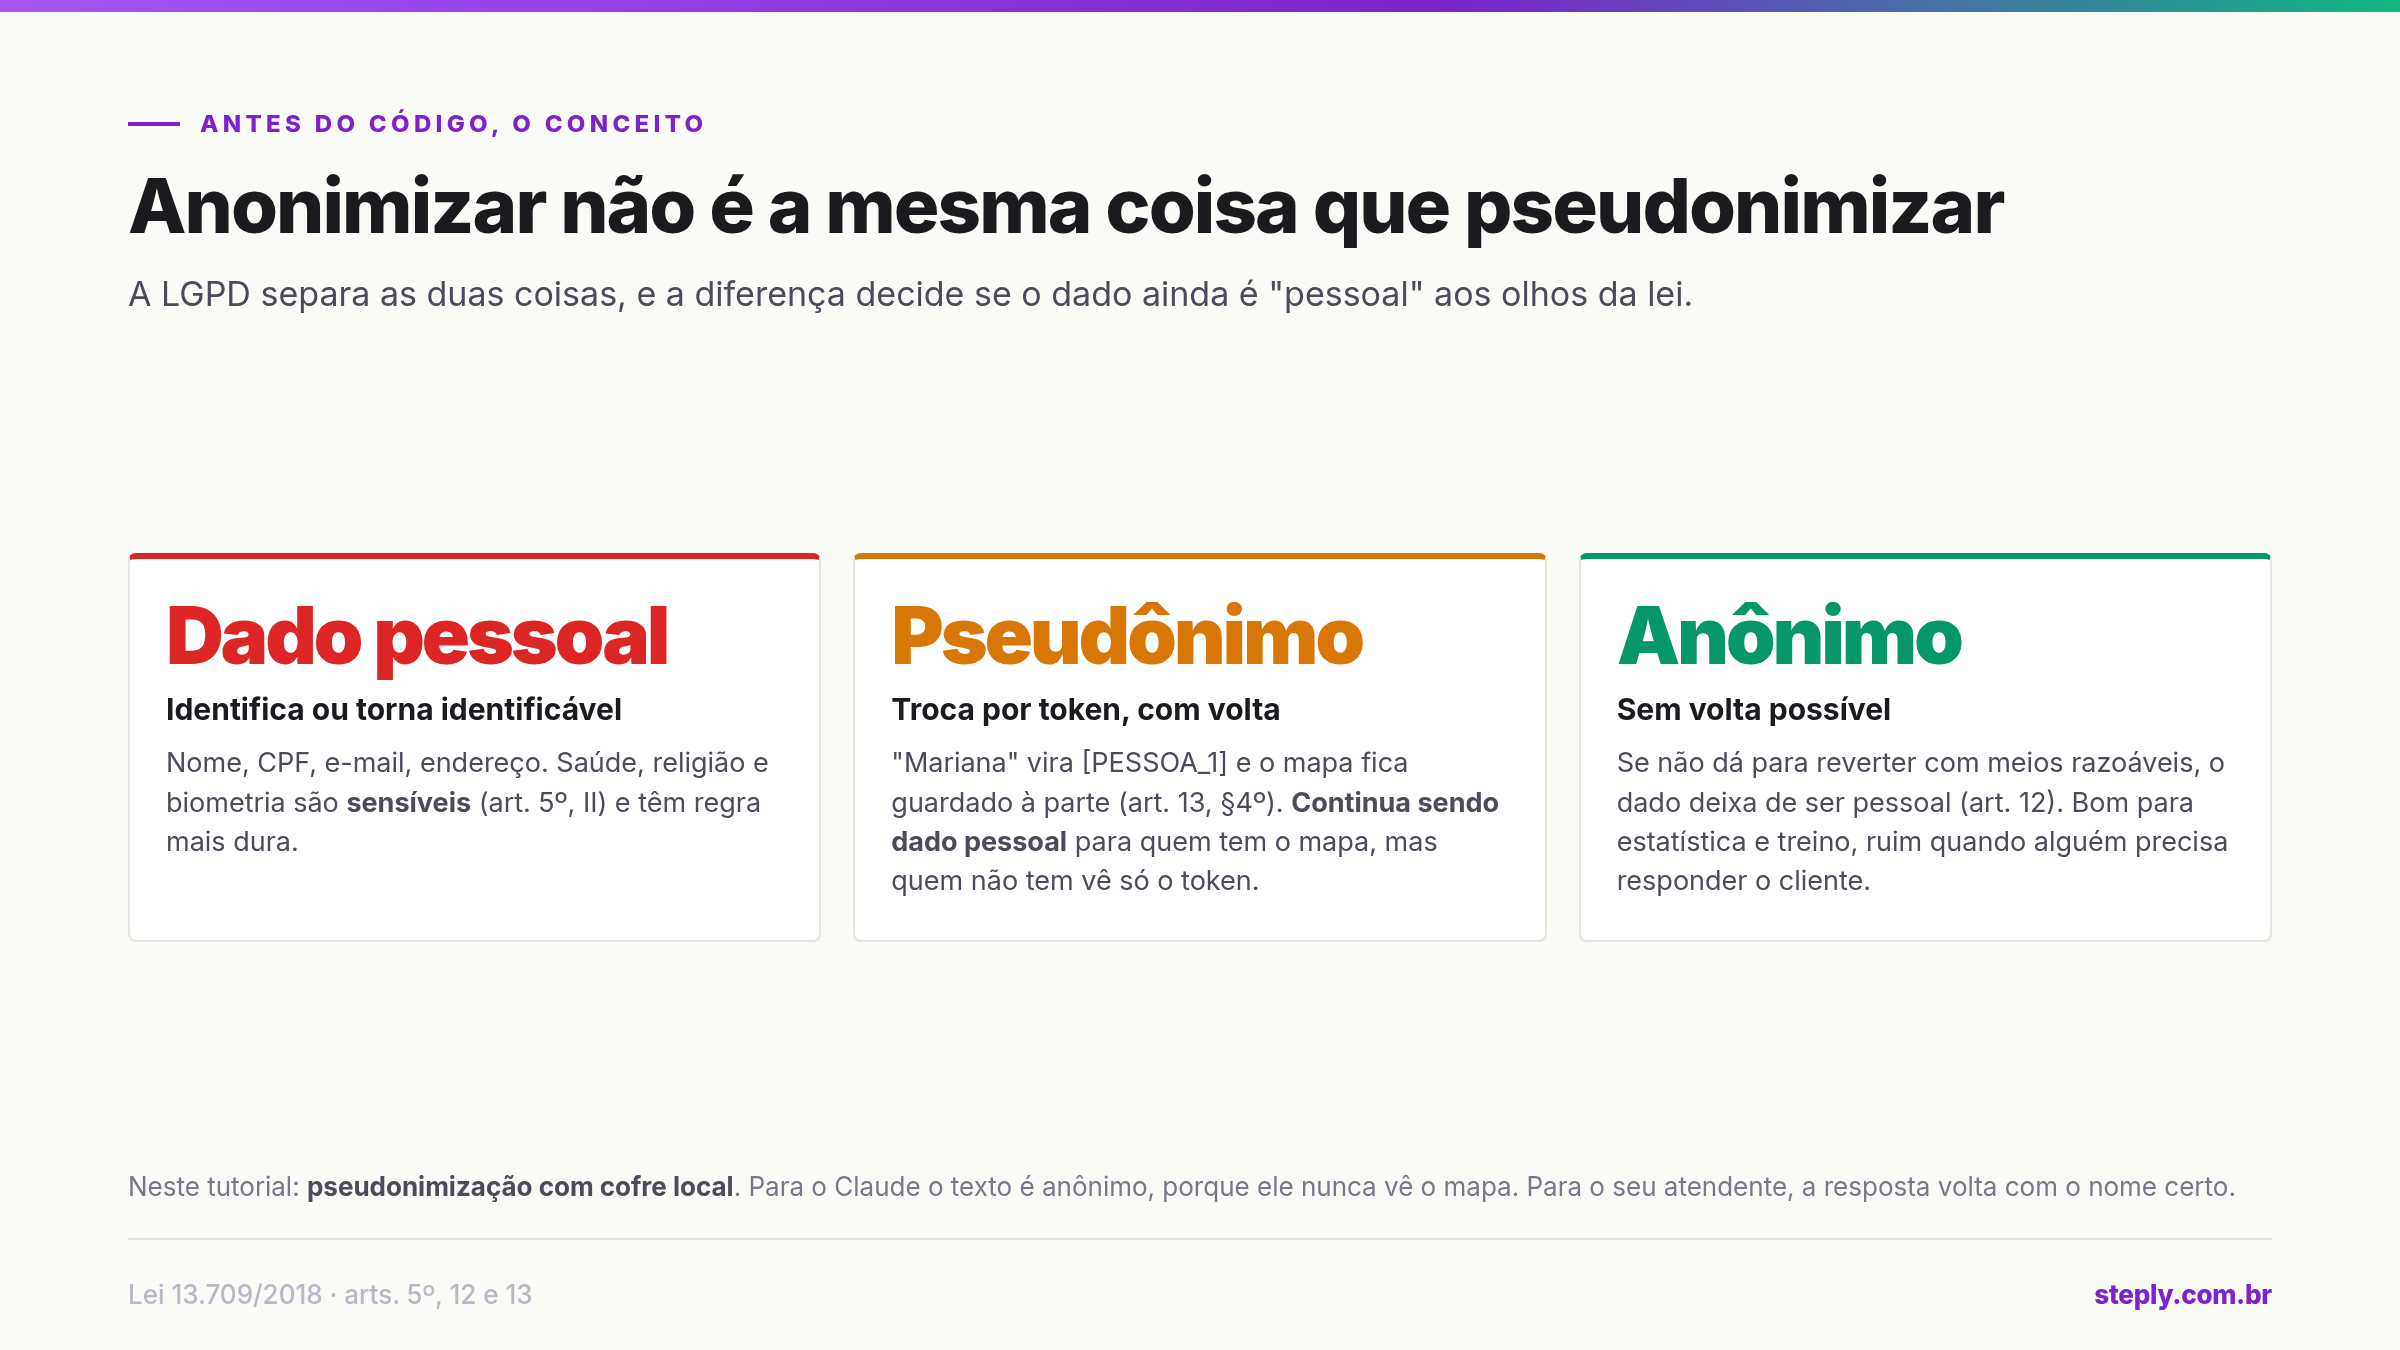
A LGPD separa três situações, e vale entender antes de escrever uma linha:
- Dado pessoal é o que identifica ou torna identificável uma pessoa (art. 5º, I). Saúde, religião, biometria e afins são sensíveis (art. 5º, II).
- Pseudonimização troca o dado por um código e guarda a tabela de volta em lugar separado (art. 13, §4º). Para quem tem a tabela, continua sendo dado pessoal.
- Anonimização é quando não dá mais para voltar com meios razoáveis. Aí o dado deixa de ser pessoal (art. 12).
Para atendimento, precisamos voltar: o atendente tem que responder a Mariana, não a "[PESSOA_1]". Então o que vamos construir é pseudonimização com cofre local. Para o Claude, o texto é anônimo, porque ele nunca vê a tabela. Para o seu time, a resposta volta com o nome certo.
O desenho: duas camadas, um cofre e uma trava
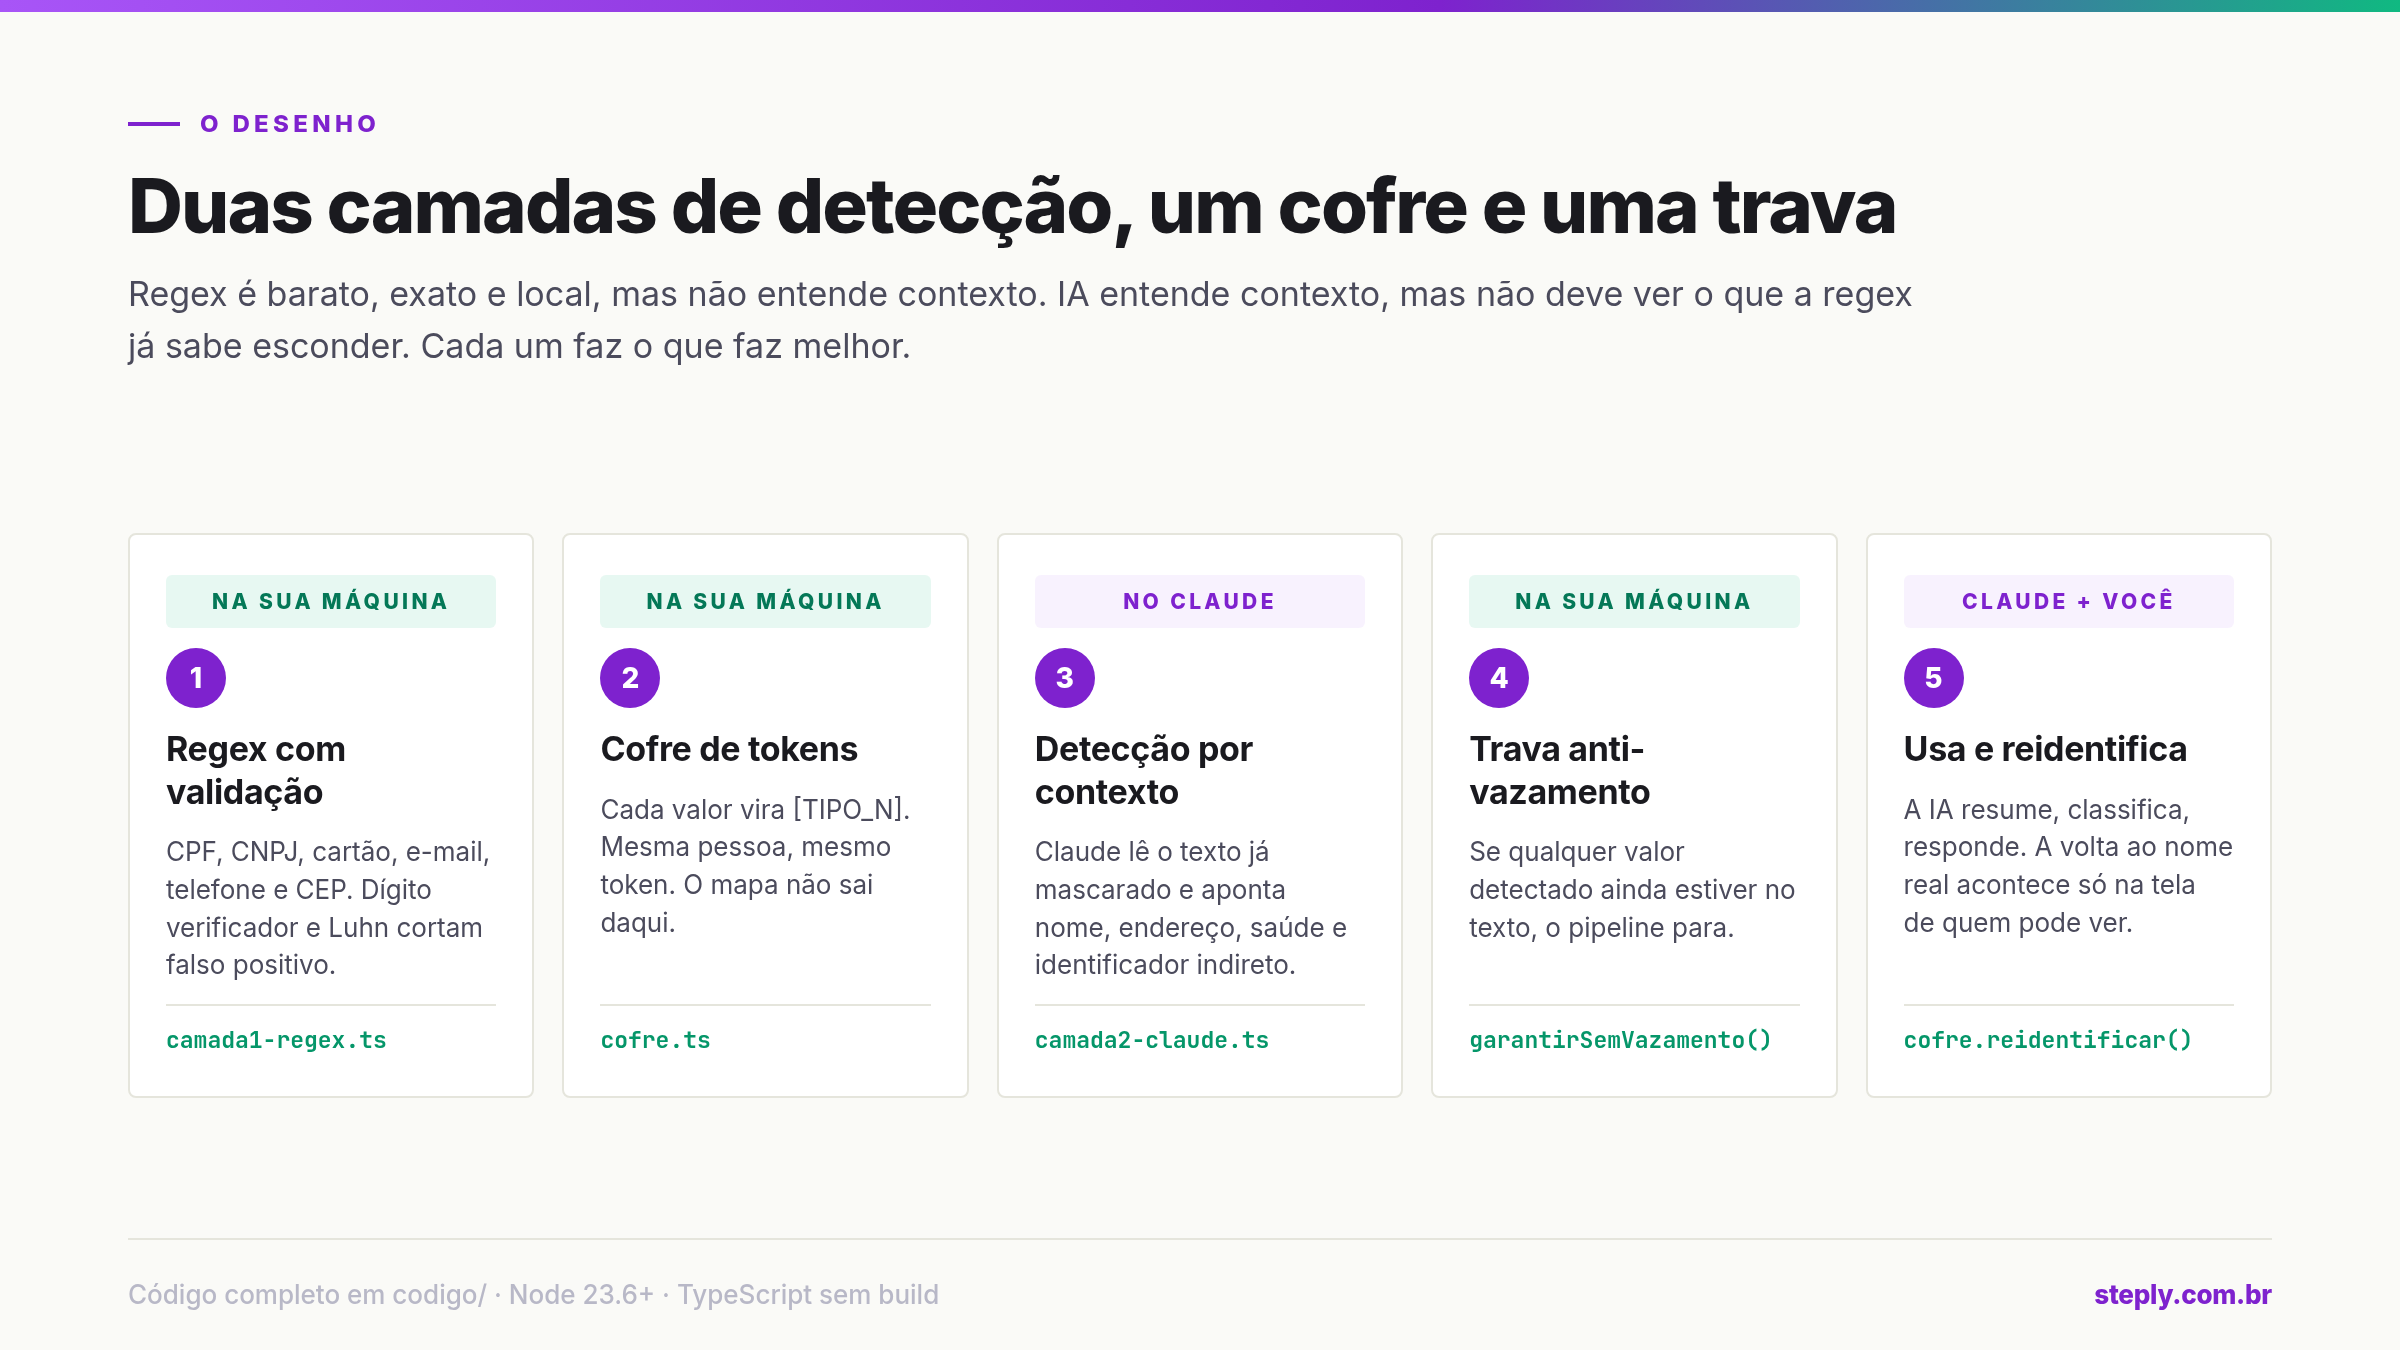
Regex é barata, exata e roda na sua máquina, mas não entende contexto: não sabe que "Mariana" é gente e "Acácias" é rua. IA entende contexto, mas não precisa ver o que a regex já sabe esconder. Então cada um faz o que faz melhor:
- Camada 1, regex local. CPF, CNPJ, cartão, e-mail, telefone e CEP saem aqui.
- Cofre. Cada dado vira um token com tipo, como
[CPF_1]. O mapa fica com você. - Camada 2, Claude. Recebe o texto já sem os identificadores diretos e aponta o que sobrou: nomes, endereço, saúde, identificador indireto.
- Trava. Se qualquer valor detectado ainda aparece no texto, o pipeline para.
- Uso e volta. A IA trabalha só com tokens; a reidentificação acontece na tela de quem pode ver.
Para seguir junto, você precisa de Node 23.6 ou mais novo, que roda TypeScript direto, sem build. A estrutura do projeto é esta (o código completo de cada arquivo está no fim do post):
anonimizacao/
├── package.json
├── src/
│ ├── camada1-regex.ts # passo 1
│ ├── cofre.ts # passo 2
│ ├── camada2-claude.ts # passo 3
│ ├── anonimizar.ts # orquestra e trava
│ └── demo.ts
└── test/
 └── anonimizacao.test.ts
{
 "name": "anonimizacao-com-claude",
 "private": true,
 "type": "module",
 "scripts": {
 "demo": "node src/demo.ts",
 "demo:local": "node src/demo.ts --sem-claude",
 "test": "node --test \"test/*.test.ts\""
 },
 "dependencies": {
 "@anthropic-ai/sdk": "^0.128.0",
 "zod": "^4.6.5"
 }
}
npm install
npm test # 6 testes, não chama a API
npm run demo:local # só a camada 1, sem chave
export ANTHROPIC_API_KEY=sk-ant-...
npm run demo # pipeline completo
Passo 1: o que tem formato fixo sai antes de tudo
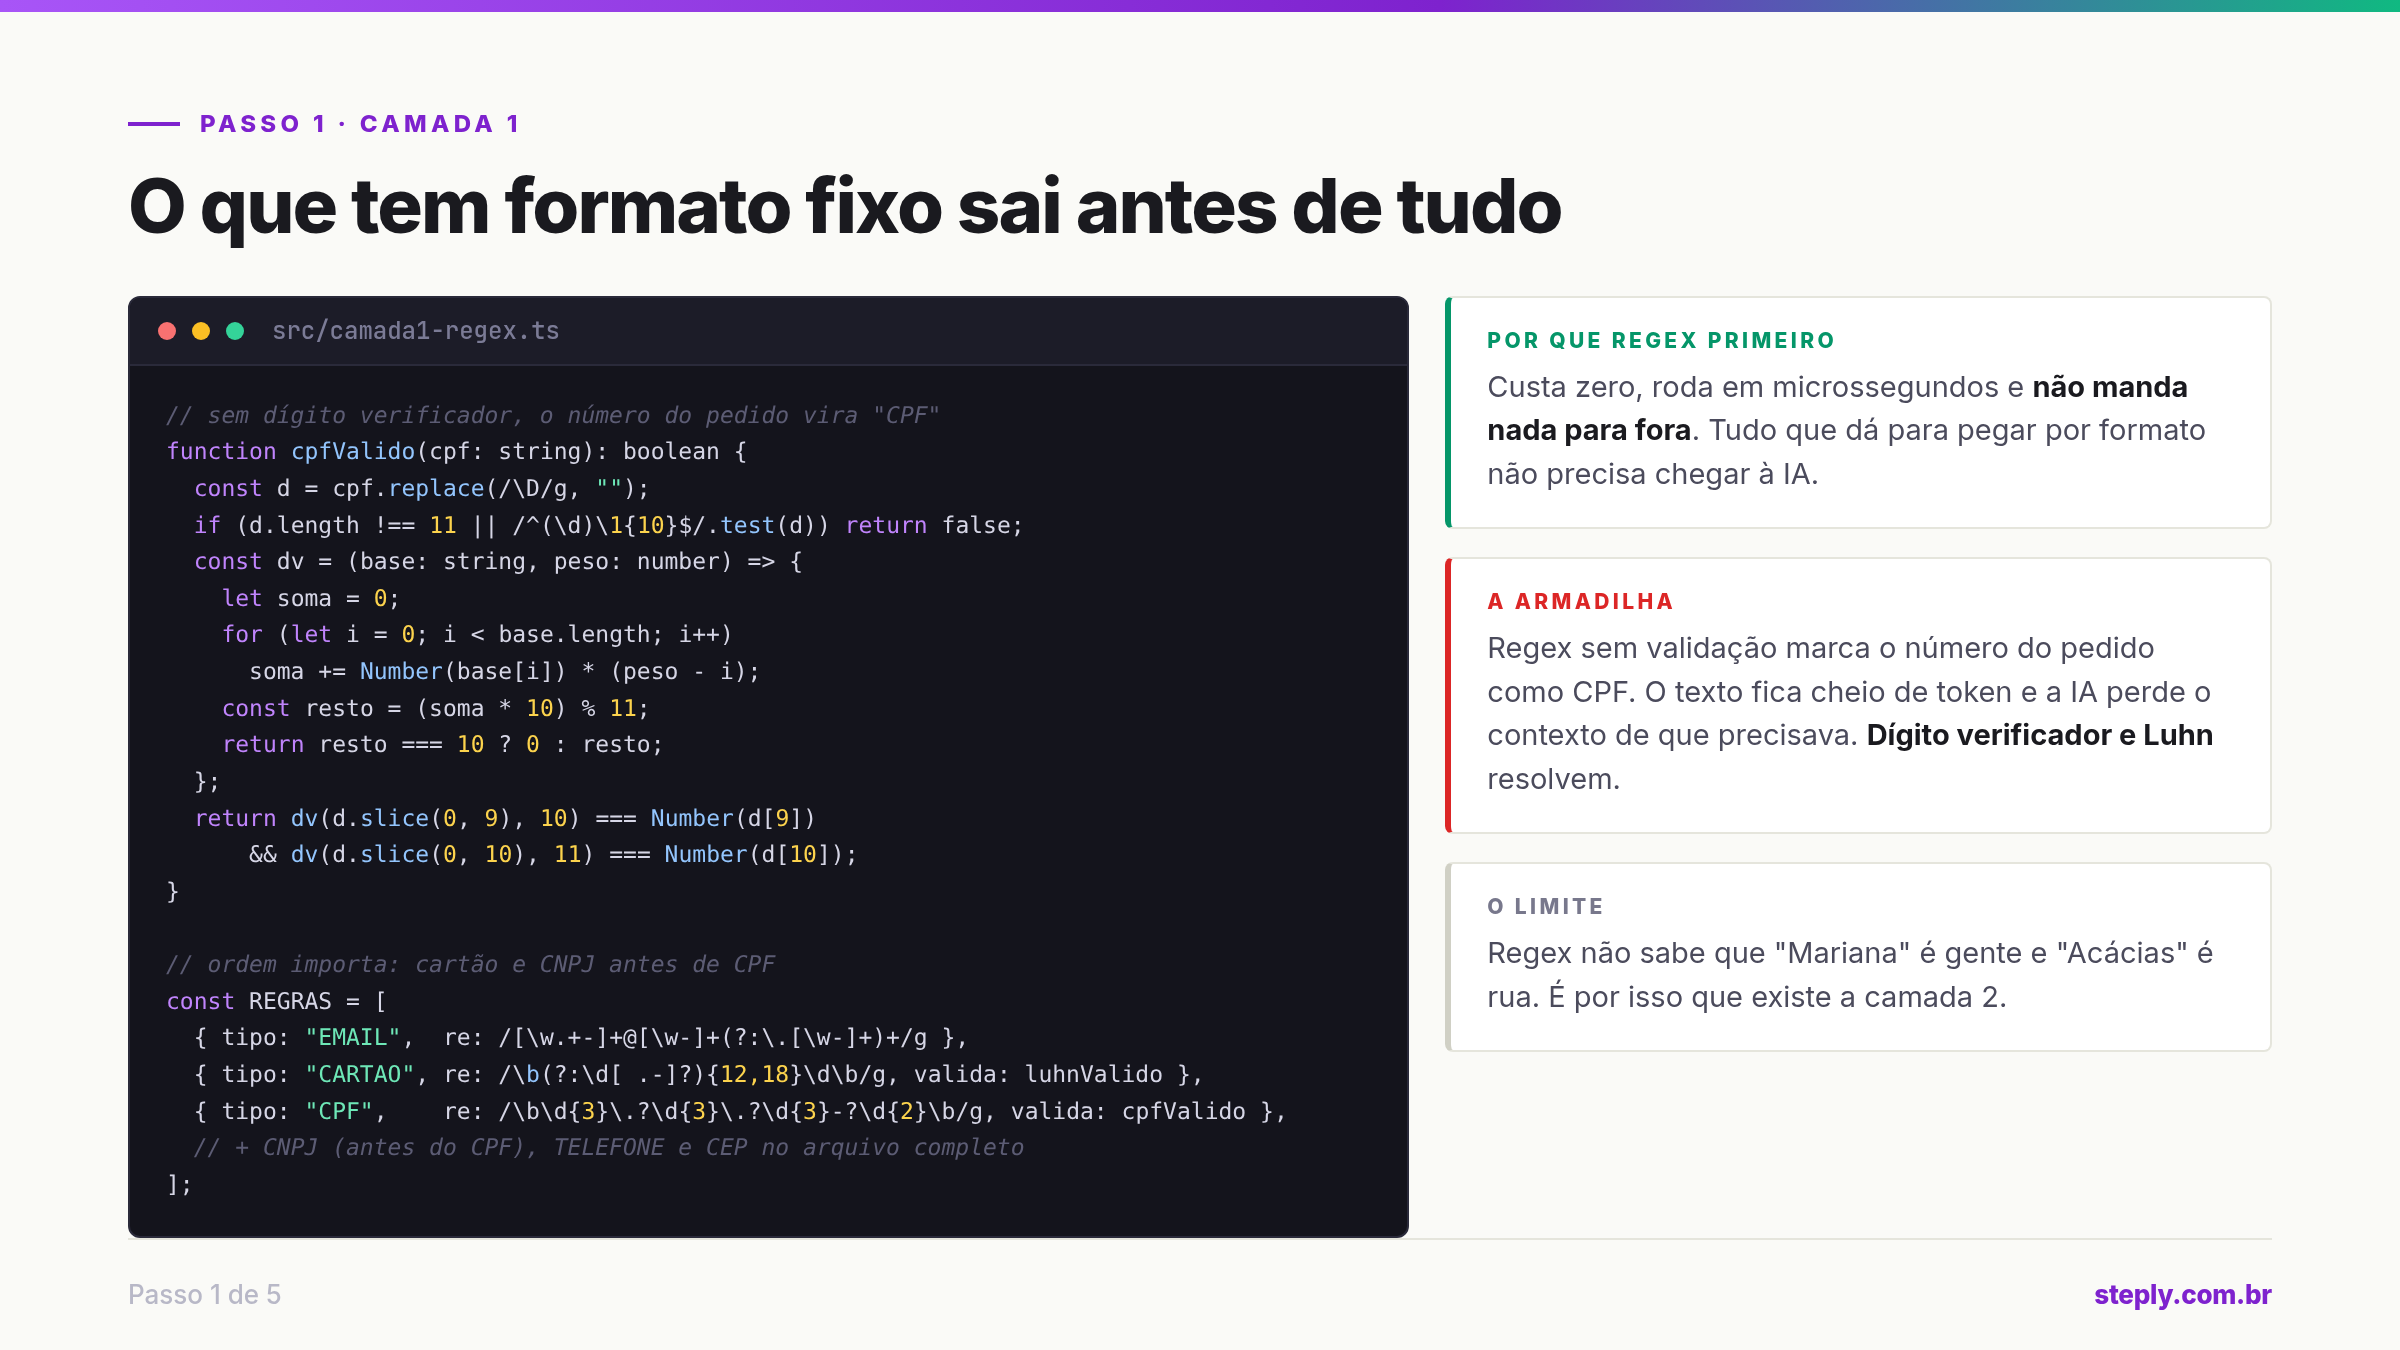
A primeira camada é regex, mas regex com validação. Sem o dígito verificador, qualquer sequência de onze números vira "CPF": número de protocolo, nota fiscal, pedido. O texto fica cheio de token e a IA perde o contexto de que precisava para ajudar.
// src/camada1-regex.ts
function cpfValido(cpf: string): boolean {
 const d = cpf.replace(/\D/g, "");
 if (d.length !== 11 || /^(\d)\1{10}$/.test(d)) return false;
 const dv = (base: string, pesoInicial: number) => {
 let soma = 0;
 for (let i = 0; i < base.length; i++) soma += Number(base[i]) * (pesoInicial - i);
 const resto = (soma * 10) % 11;
 return resto === 10 ? 0 : resto;
 };
 return dv(d.slice(0, 9), 10) === Number(d[9]) && dv(d.slice(0, 10), 11) === Number(d[10]);
}
O cartão usa o algoritmo de Luhn, o mesmo que a bandeira usa. O CNPJ tem a sua própria conta de dígito. E a ordem das regras importa: cartão e CNPJ vêm antes do CPF, senão um pedaço do número maior é capturado pela regra menor.
const REGRAS: Regra[] = [
 { tipo: "EMAIL", re: /[\w.+-]+@[\w-]+(?:\.[\w-]+)+/g },
 { tipo: "CARTAO", re: /\b(?:\d[ .-]?){12,18}\d\b/g, valida: luhnValido },
 { tipo: "CNPJ", re: /\b\d{2}\.?\d{3}\.?\d{3}\/?\d{4}-?\d{2}\b/g, valida: cnpjValido },
 { tipo: "CPF", re: /\b\d{3}\.?\d{3}\.?\d{3}-?\d{2}\b/g, valida: cpfValido },
 { tipo: "TELEFONE", re: /(?:\+?55\s?)?\(?\b\d{2}\)?\s?9?\d{4}[-\s]?\d{4}\b/g },
 { tipo: "CEP", re: /\b\d{5}-\d{3}\b/g },
];
Rodando só essa camada, sem chave de API nenhuma:
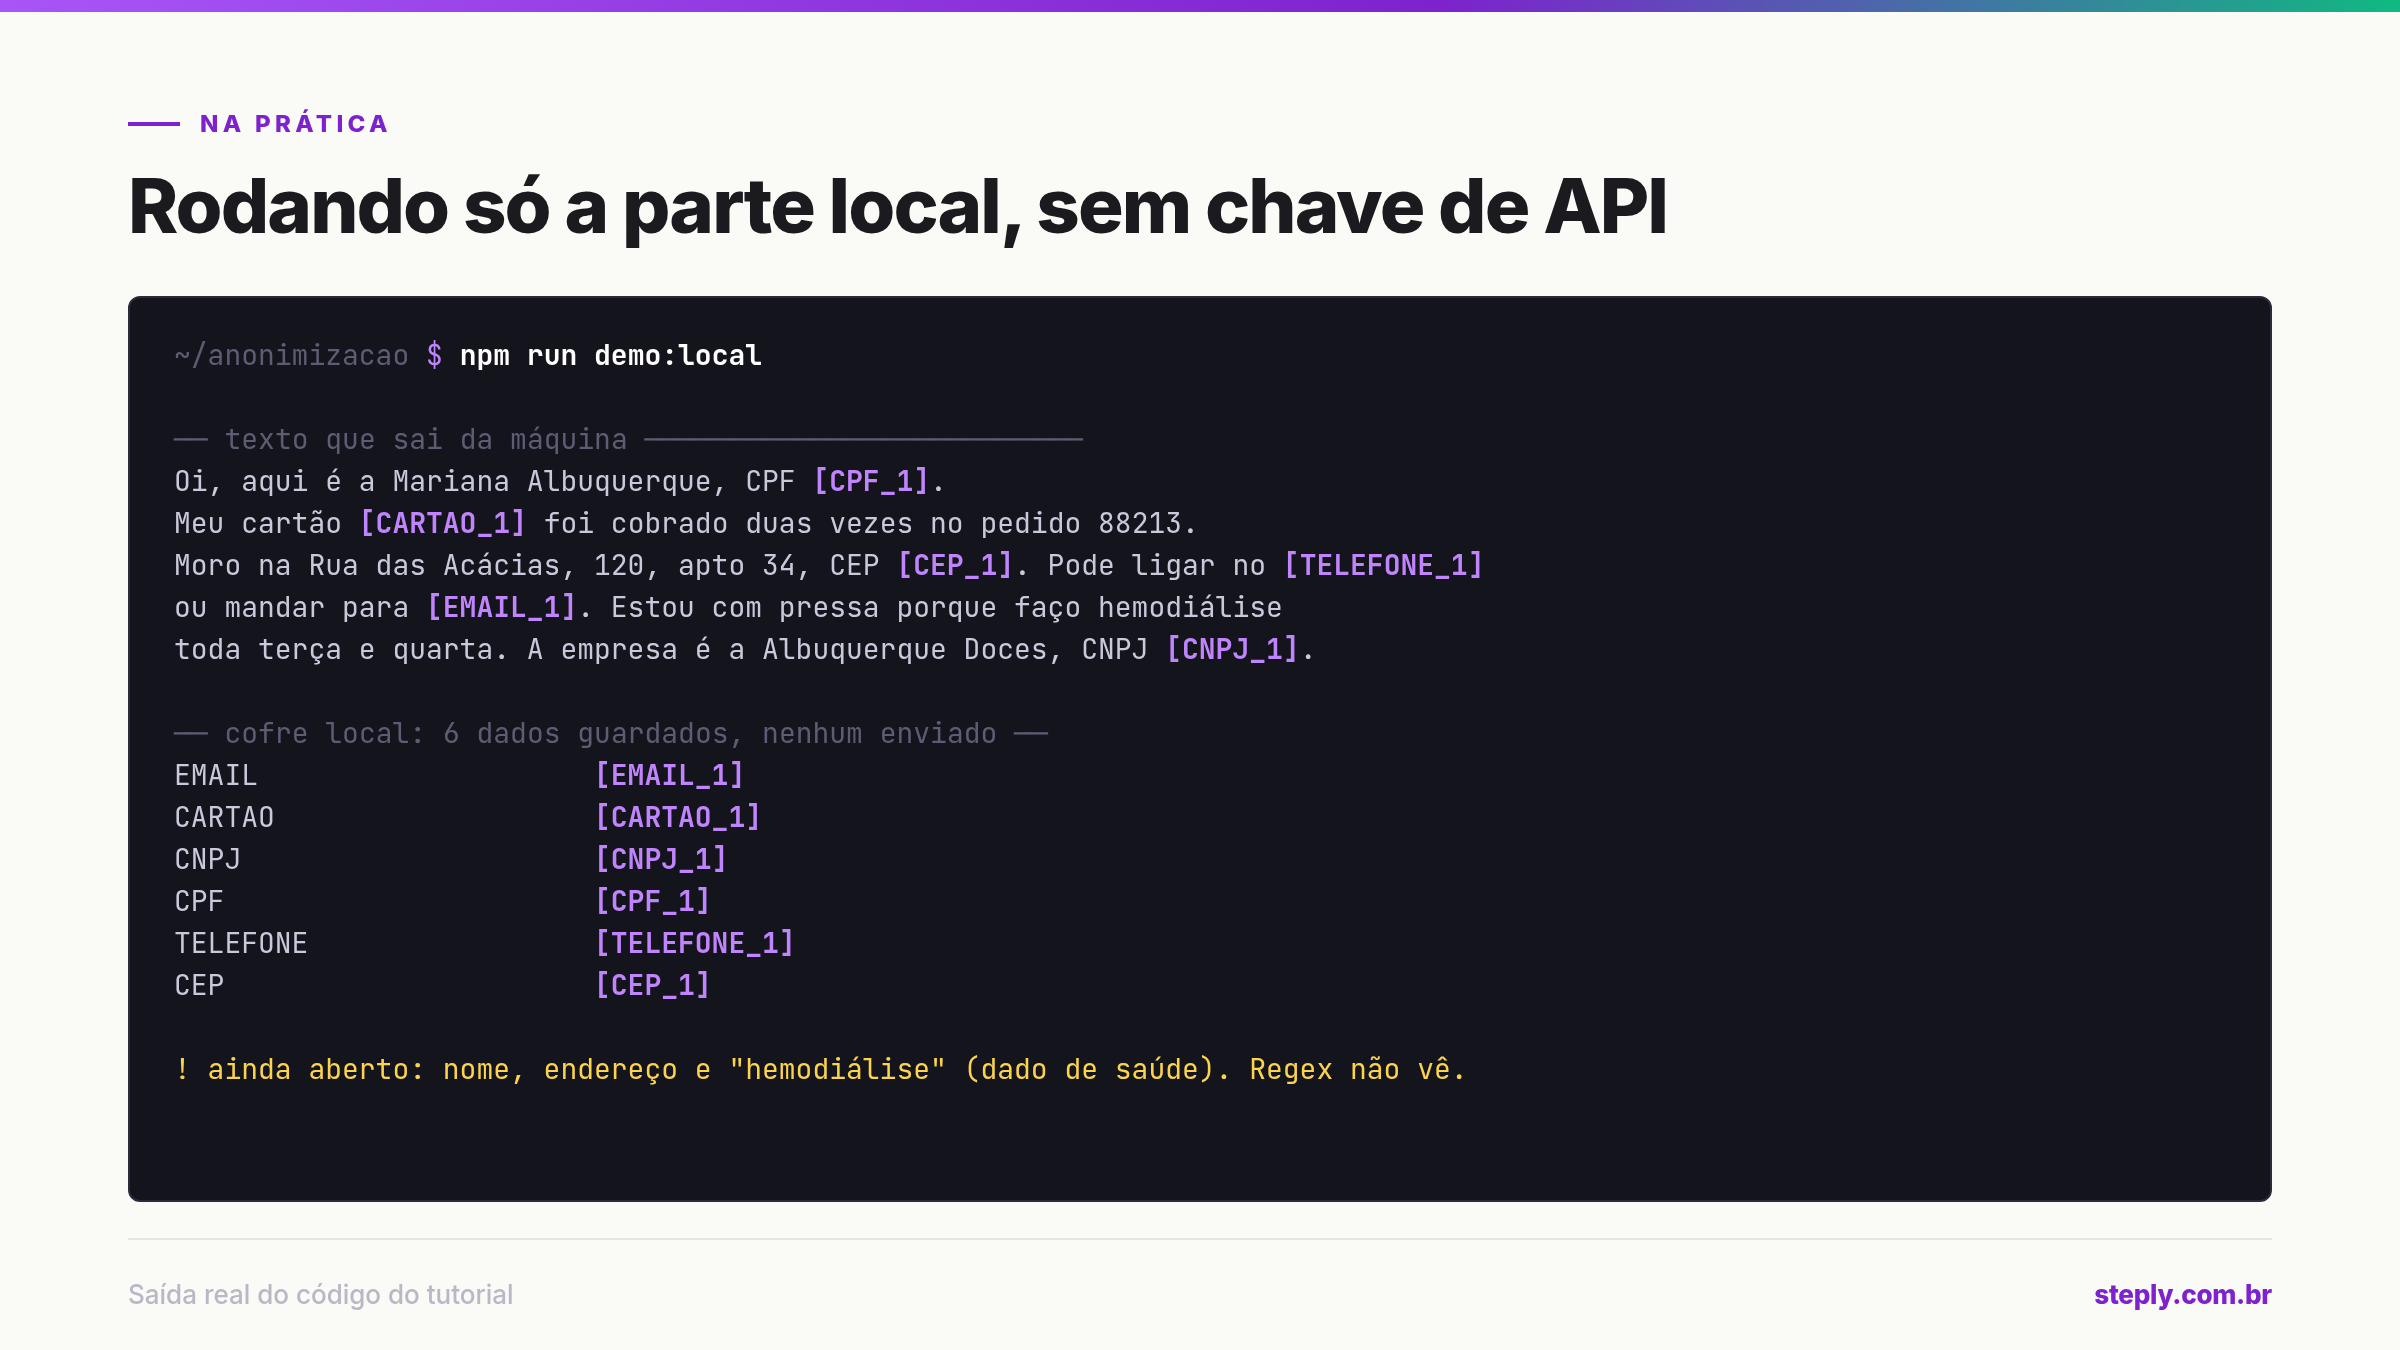
Seis dados saíram sem nada deixar a máquina. Mas olhe o que ficou: o nome da Mariana, o endereço por extenso e a hemodiálise. Regex não enxerga isso. É para esse resto que existe a segunda camada.
Passo 2: um token por pessoa, e o mapa fica em casa
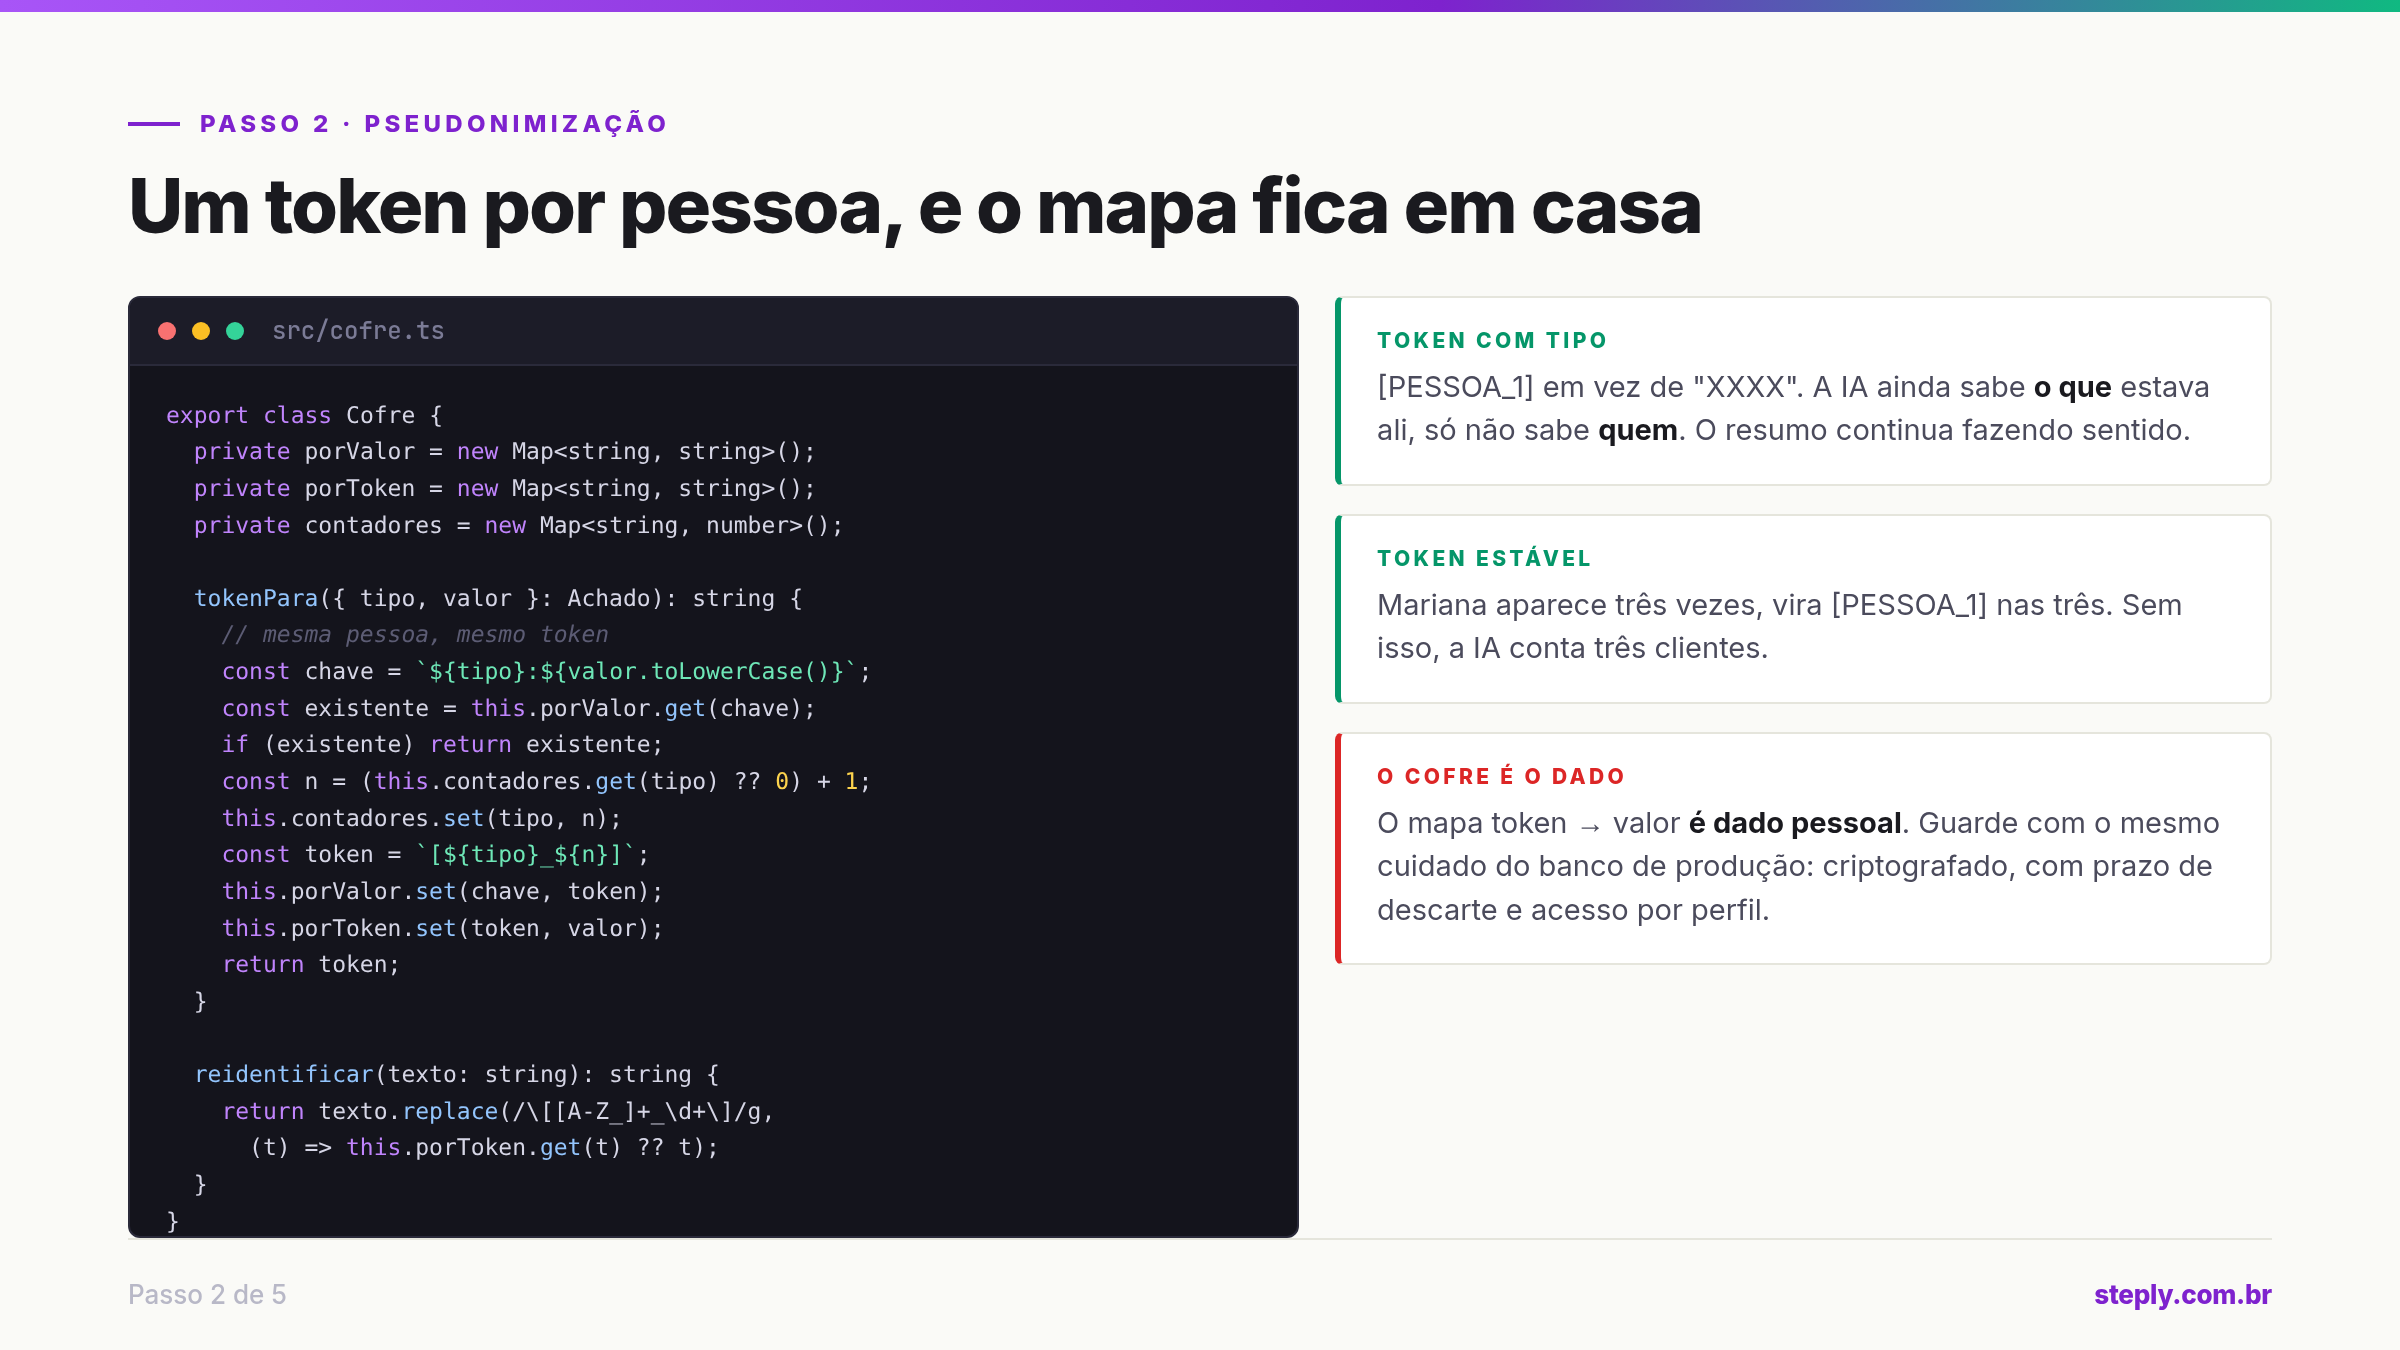
O cofre troca cada valor por um token e guarda a volta. Três decisões fazem diferença:
Token com tipo. [PESSOA_1] em vez de XXXX. A IA continua sabendo o que estava
ali, só não sabe quem. Um resumo feito sobre "cliente [PESSOA_1] com cobrança
duplicada no cartão [CARTAO_1]" faz sentido. Um resumo sobre "XXXX com cobrança no XXXX"
não faz.
Token estável. Se a Mariana aparece três vezes, ela vira [PESSOA_1] nas três.
Sem isso a IA entende que são três clientes diferentes.
O cofre é o dado. O mapa token para valor é dado pessoal. Ele merece o mesmo cuidado do banco de produção: criptografado, com prazo de descarte e acesso por perfil. Nunca no mesmo lugar dos logs.
// src/cofre.ts
tokenPara({ tipo, valor }: Achado): string {
 const chave = `${tipo}:${valor.toLowerCase()}`;
 const existente = this.porValor.get(chave);
 if (existente) return existente;
 const n = (this.contadores.get(tipo) ?? 0) + 1;
 this.contadores.set(tipo, n);
 const token = `[${tipo}_${n}]`;
 this.porValor.set(chave, token);
 this.porToken.set(token, valor);
 return token;
}

reidentificar(texto: string): string {
 return texto.replace(/\[[A-Z_]+_\d+\]/g, (t) => this.porToken.get(t) ?? t);
}
Passo 3: o Claude aponta, o seu código troca
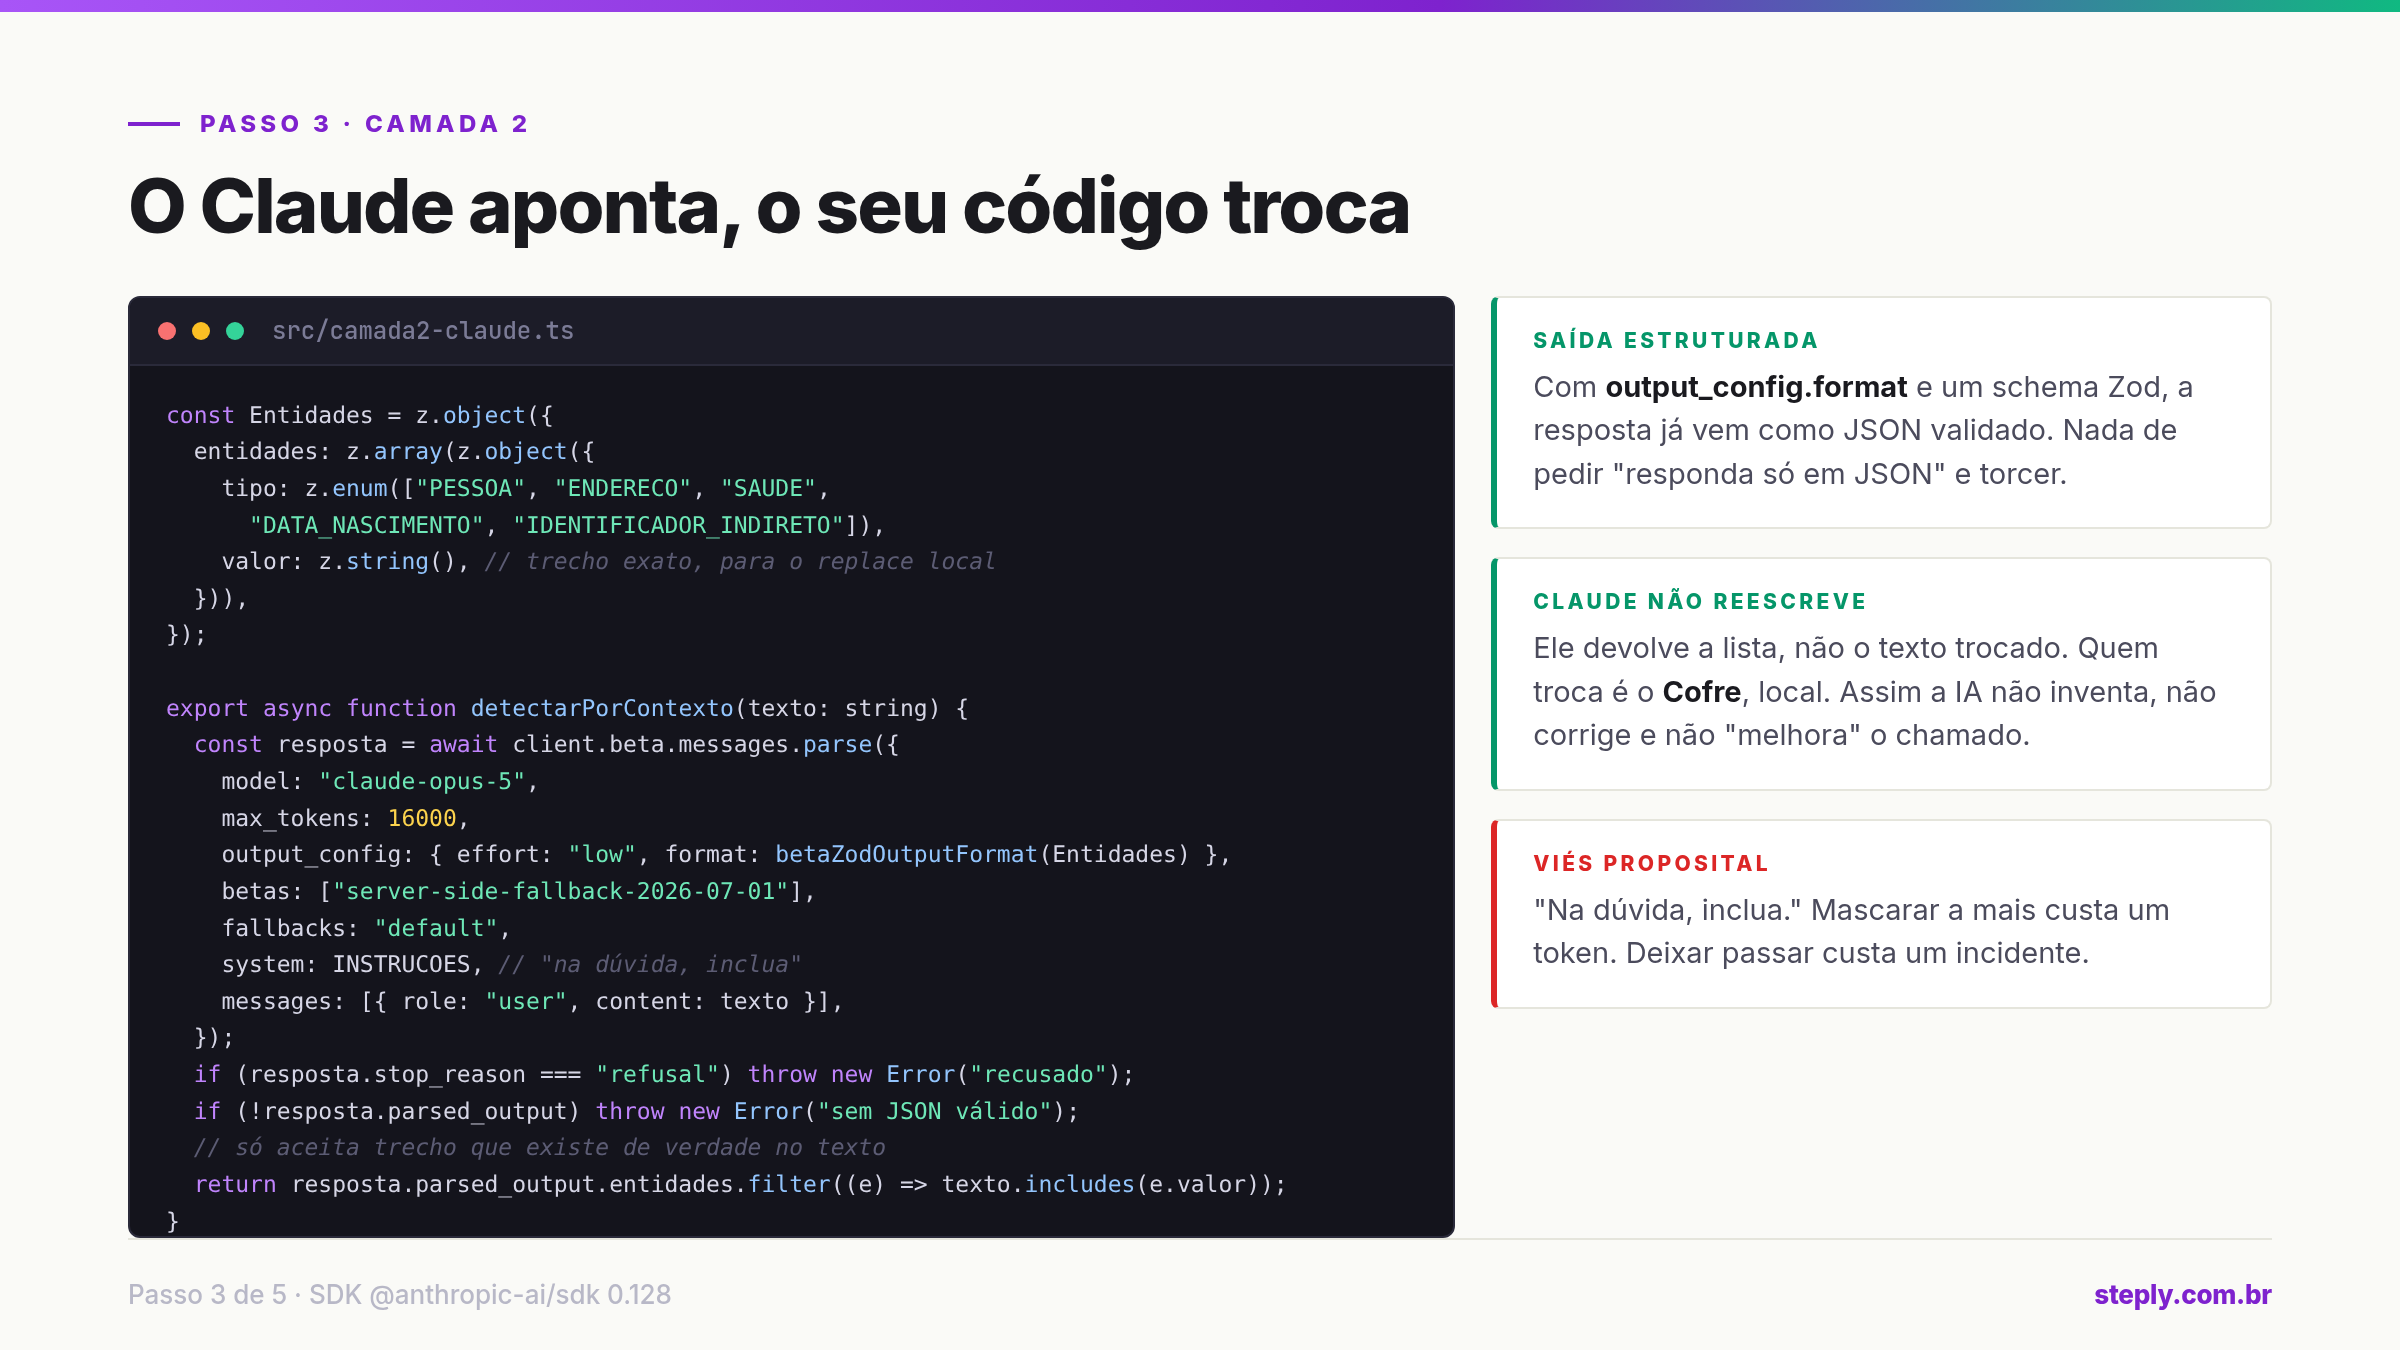
Aqui entra a IA. O detalhe mais importante do tutorial inteiro está nesta frase: o Claude não devolve o texto reescrito. Ele devolve a lista do que achou, e quem troca é o nosso código. Se você pede para a IA "reescrever o texto sem dados pessoais", ela pode corrigir uma vírgula, resumir um trecho, mudar uma data. Pedindo só a lista, o texto original fica intacto e a troca é exata.
Para a lista vir sempre no formato certo, usamos saída estruturada: um schema Zod passado
em output_config.format. A resposta já chega validada, sem precisar pedir "responda só
em JSON" e torcer.
// src/camada2-claude.ts
const Entidades = z.object({
 entidades: z.array(
 z.object({
 tipo: z.enum(["PESSOA", "ENDERECO", "SAUDE", "DATA_NASCIMENTO", "IDENTIFICADOR_INDIRETO"]),
 valor: z.string(),
 }),
 ),
});

export async function detectarPorContexto(texto: string): Promise<Achado[]> {
 const resposta = await client.beta.messages.parse({
 model: "claude-opus-5",
 max_tokens: 16000,
 output_config: { effort: "low", format: betaZodOutputFormat(Entidades) },
 betas: ["server-side-fallback-2026-07-01"],
 fallbacks: "default",
 system: INSTRUCOES,
 messages: [{ role: "user", content: texto }],
 });

 if (resposta.stop_reason === "refusal") {
 throw new Error("Claude recusou a análise; o texto não deve seguir adiante sem revisão.");
 }
 if (!resposta.parsed_output) {
 throw new Error(`resposta sem JSON válido (stop_reason: ${resposta.stop_reason})`);
 }
 return resposta.parsed_output.entidades.filter((e) => texto.includes(e.valor));
}
Quatro escolhas nesse trecho merecem explicação:
effort: "low". Detectar entidade é tarefa de leitura, não de raciocínio longo. Esforço baixo deixa a chamada mais rápida e mais barata sem perder qualidade aqui.fallbacks: "default". Se o modelo principal recusar o pedido, a própria API tenta de novo em um modelo reserva, na mesma chamada.- Recusa ou JSON inválido param o pipeline. Nunca "segue sem a camada 2". Texto que não passou pela análise não sai.
- O filtro final. Só aceitamos trechos que existem de verdade no texto. Se a IA devolver um nome com grafia corrigida, ele é descartado em vez de gerar uma troca errada.
O prompt de sistema tem um viés proposital: na dúvida, inclua. Mascarar a mais custa um token a mais no texto. Deixar passar custa um incidente.
Você é um detector de dados pessoais (LGPD) em textos em português.
Liste cada trecho que identifica ou torna identificável uma pessoa natural:
- PESSOA: nome ou apelido de pessoa (não de empresa, produto ou cidade).
- ENDERECO: rua, número, complemento, bairro quando vier junto de um endereço.
- SAUDE: diagnóstico, doença, medicamento, exame ou condição de saúde.
- DATA_NASCIMENTO: data de nascimento ou idade exata junto de outro dado.
- IDENTIFICADOR_INDIRETO: descrição que aponta para uma pessoa só.
Copie o trecho exatamente como está no texto, sem corrigir grafia.
Tokens entre colchetes como [CPF_1] já foram anonimizados: ignore.
Na dúvida, inclua.
Uma observação honesta: na camada 2, o nome e o endereço ainda chegam ao Claude, porque é justamente isso que ele precisa ler para apontar. O que a arquitetura garante é que CPF, cartão, e-mail, telefone e documento nunca saem, e que a tarefa final (resumir, classificar, responder) é feita sobre texto só com tokens. Para dado de saúde em volume, confira no contrato com o provedor as condições de retenção e de uso dos dados, e se a sua operação exige processamento em região específica.
Juntando tudo
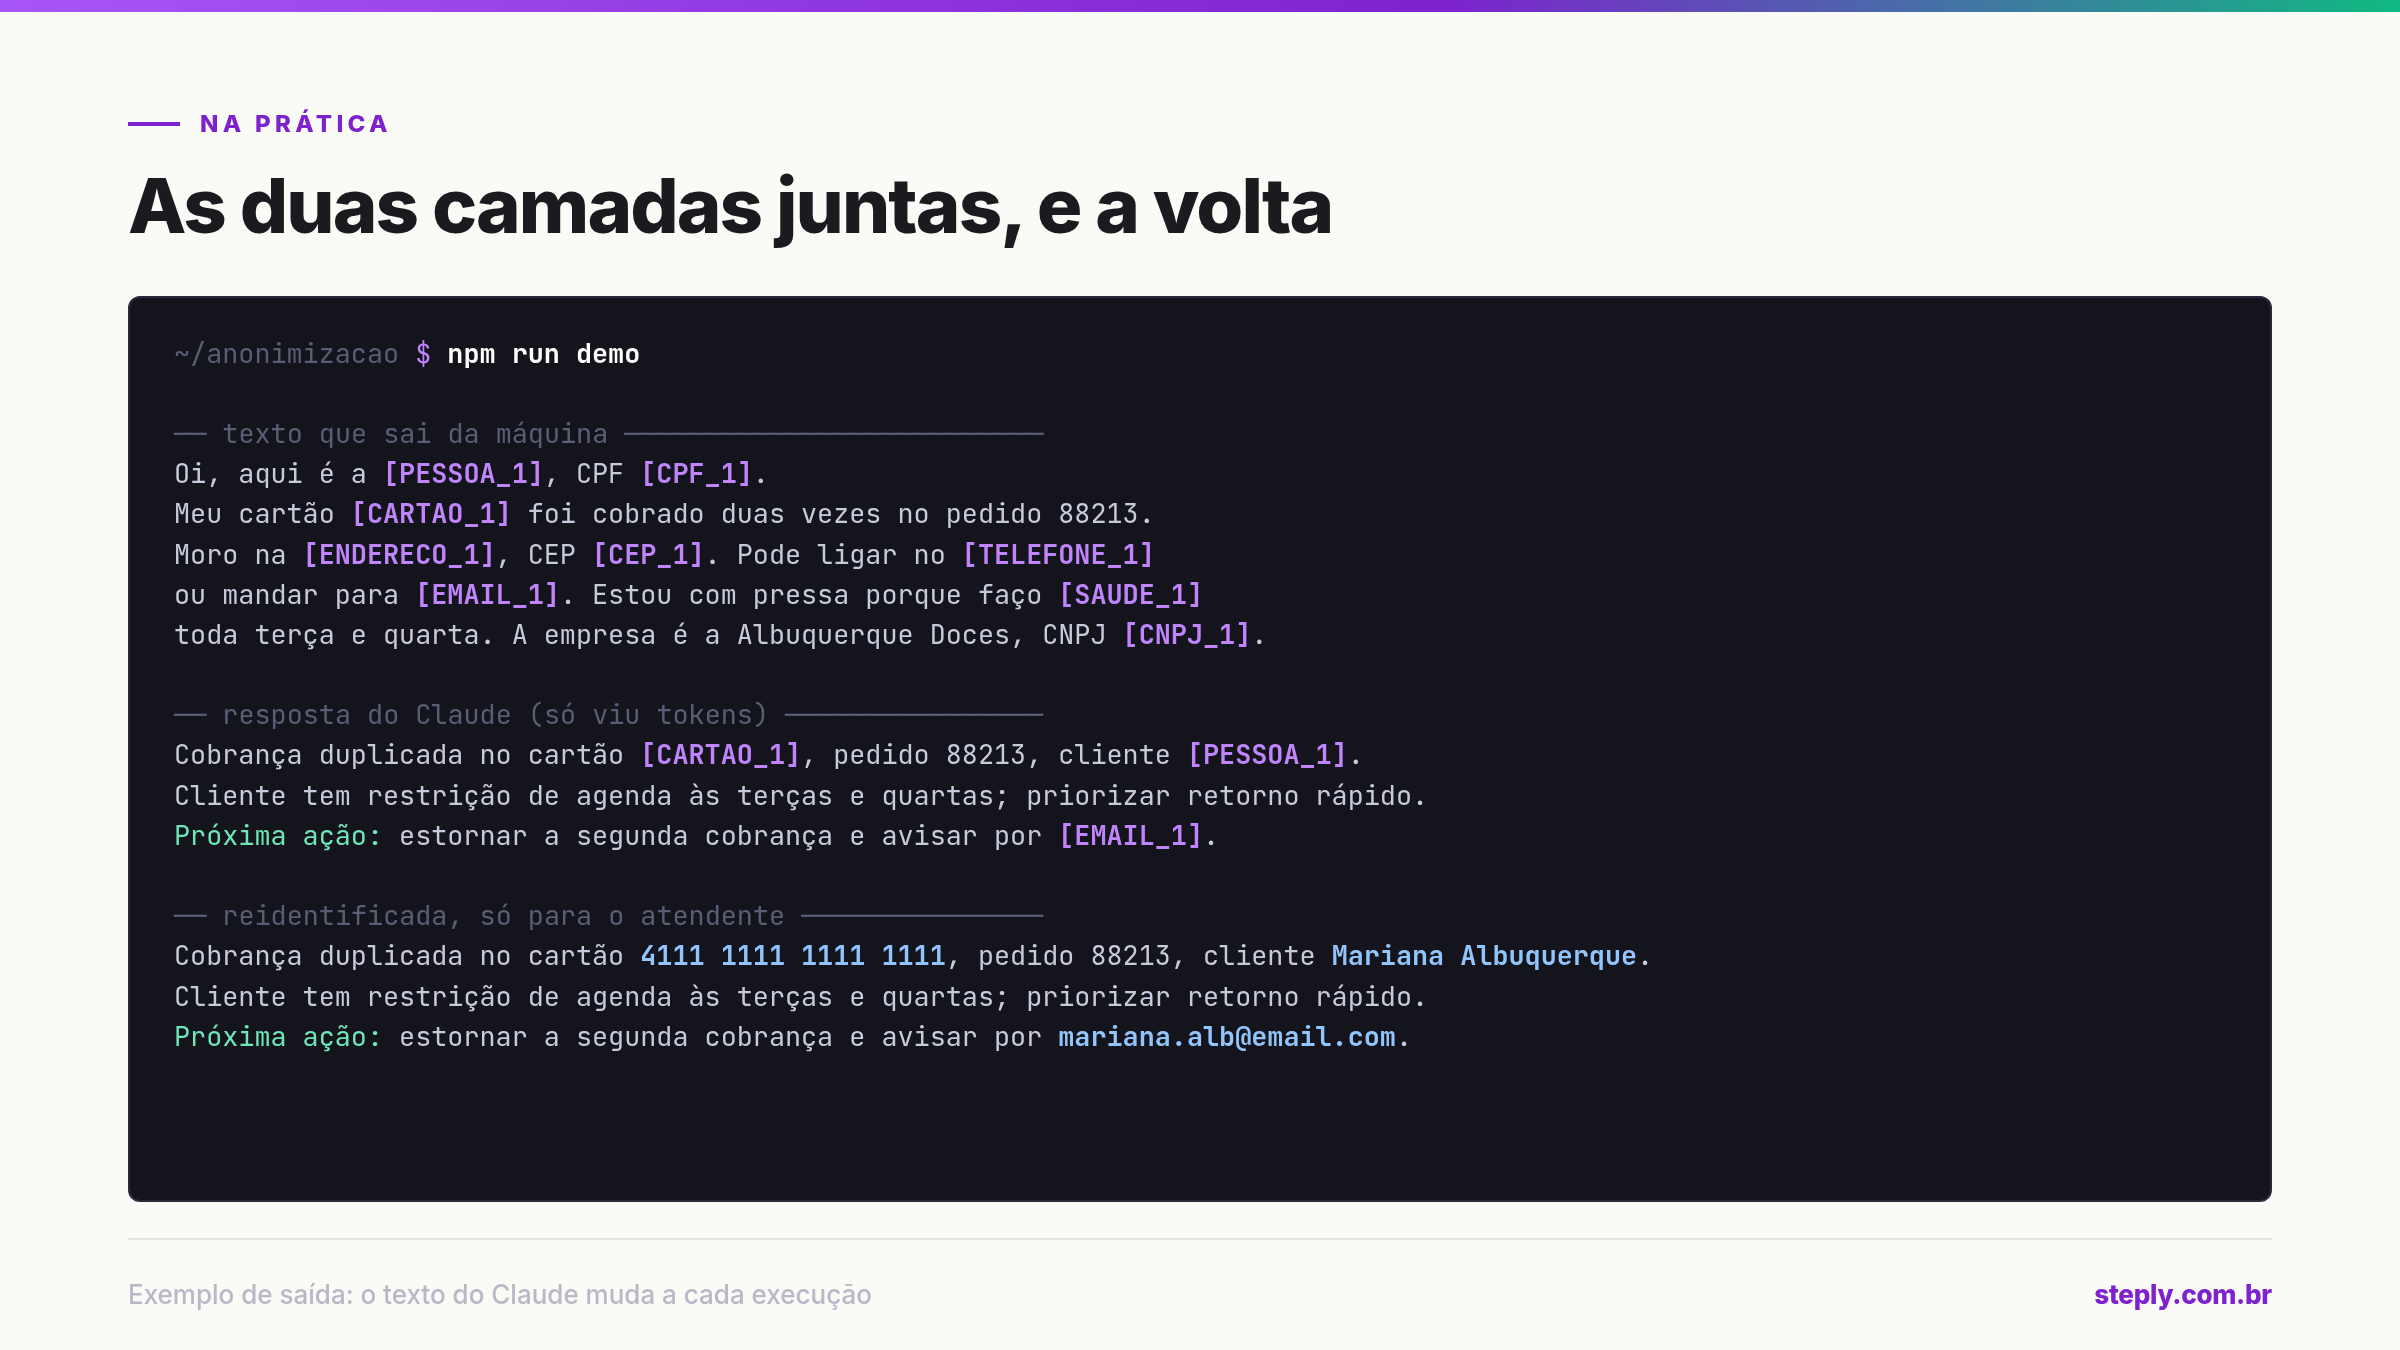
O orquestrador tem quinze linhas. A ordem é o que importa: regex primeiro, IA depois, trava no fim.
// src/anonimizar.ts
export async function anonimizar(texto: string, cofre: Cofre, contexto?: Detector) {
 const porPadrao = detectarPorPadrao(texto);
 const etapa1 = cofre.substituir(texto, porPadrao);

 const porContexto = contexto ? await contexto(etapa1) : [];
 const final = cofre.substituir(etapa1, porContexto);

 return { texto: final, achados: [...porPadrao, ...porContexto] };
}
Depois disso, o texto anonimizado pode ir para qualquer tarefa: resumo, classificação,
resposta sugerida. No exemplo, pedimos ao Claude um resumo com próxima ação e a
instrução de manter os tokens como estão. A resposta volta com [PESSOA_1] e
[CARTAO_1], e só na tela do atendente o cofre.reidentificar() coloca o nome e o
cartão de volta. O Claude resolveu o chamado sem saber de quem era. (O texto do resumo
na imagem é um exemplo: a redação do Claude muda a cada execução, os tokens não.)
Passo 4: vazamento zero é regra de parada, não meta
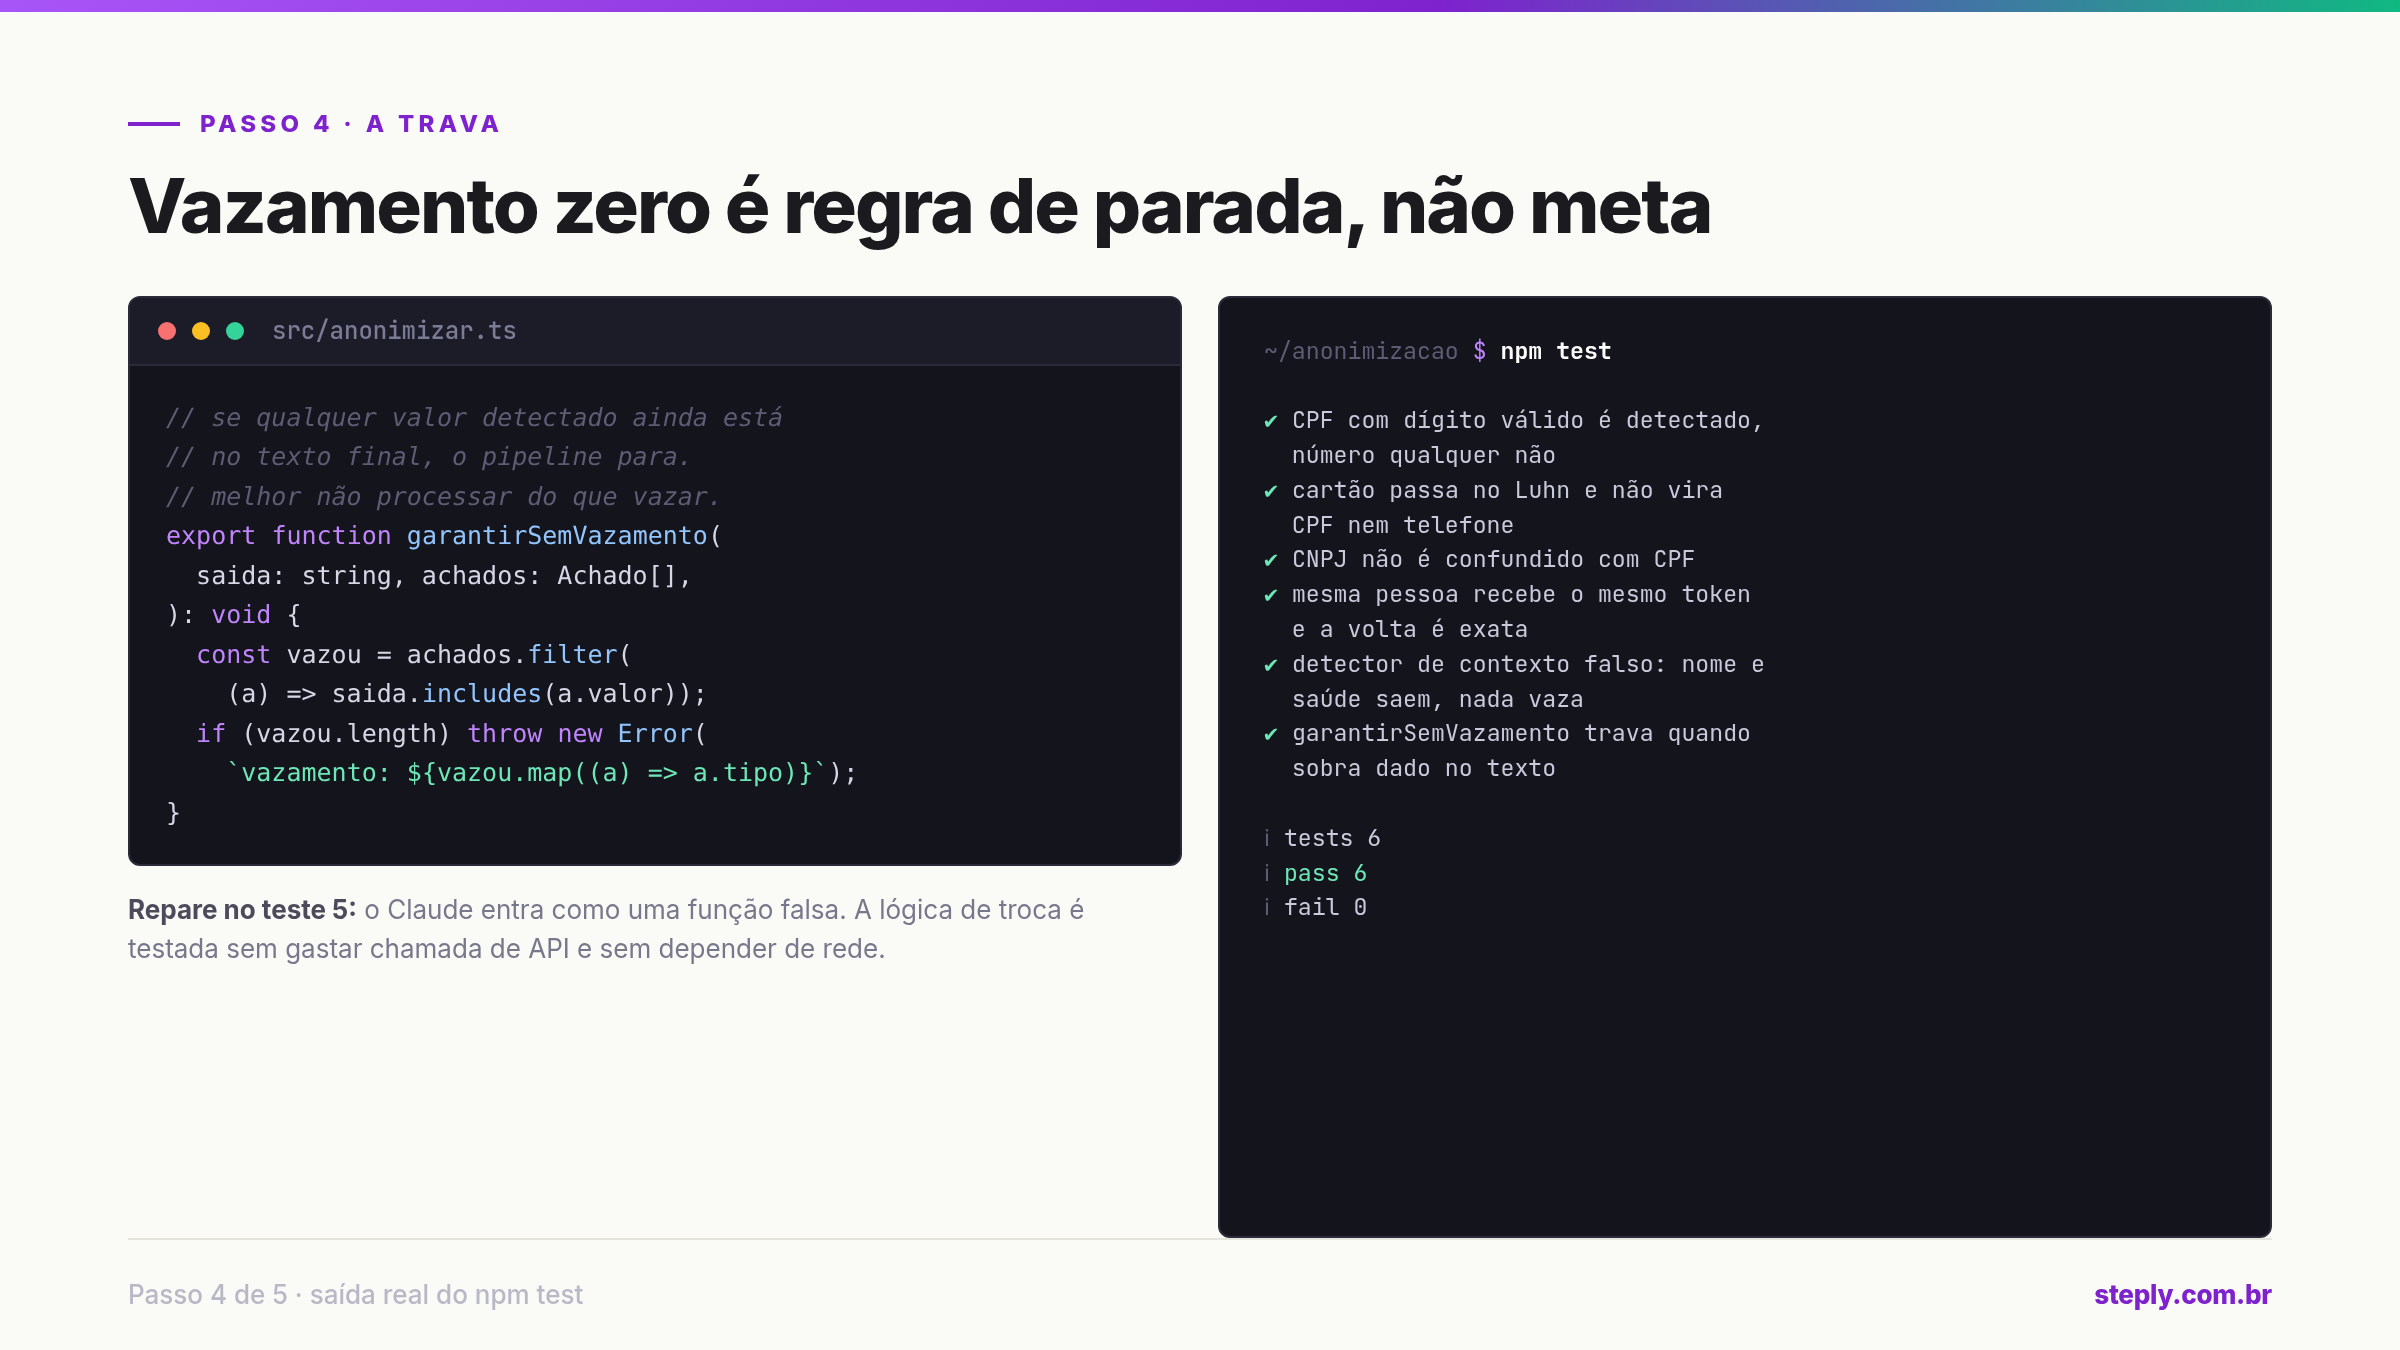
Todo pipeline de anonimização precisa de uma última barreira que não confia em ninguém, nem na regex nem na IA. A nossa é simples: se qualquer valor detectado ainda aparece no texto final, lança erro e nada é enviado.
export function garantirSemVazamento(saida: string, achados: Achado[]): void {
 const vazou = achados.filter((a) => saida.includes(a.valor));
 if (vazou.length) {
 throw new Error(`vazamento: ${vazou.map((a) => a.tipo).join(", ")}`);
 }
}
E os testes cobrem os dois lados: o que deve ser pego (CPF válido, cartão que passa no Luhn) e o que não deve (um número qualquer com cara de CPF, um CNPJ confundido com CPF). O quinto teste mostra um truque útil: a camada 2 entra como uma função falsa. A lógica de troca e a trava são testadas sem gastar chamada de API e sem depender de rede.
test("detector de contexto falso: nome e saúde saem, nada vaza", async () => {
 const falsoClaude = async () => [
 { tipo: "PESSOA", valor: "Mariana" },
 { tipo: "SAUDE", valor: "hemodiálise" },
 ];
 const cofre = new Cofre();
 const { texto, achados } = await anonimizar("Mariana (mariana@x.com) faz hemodiálise.", cofre, falsoClaude);
 assert.equal(texto, "[PESSOA_1] ([EMAIL_1]) faz [SAUDE_1].");
 garantirSemVazamento(texto, achados);
});
Passo 5: deixe o Claude Code escrever o anonimizador sem ver o dado real
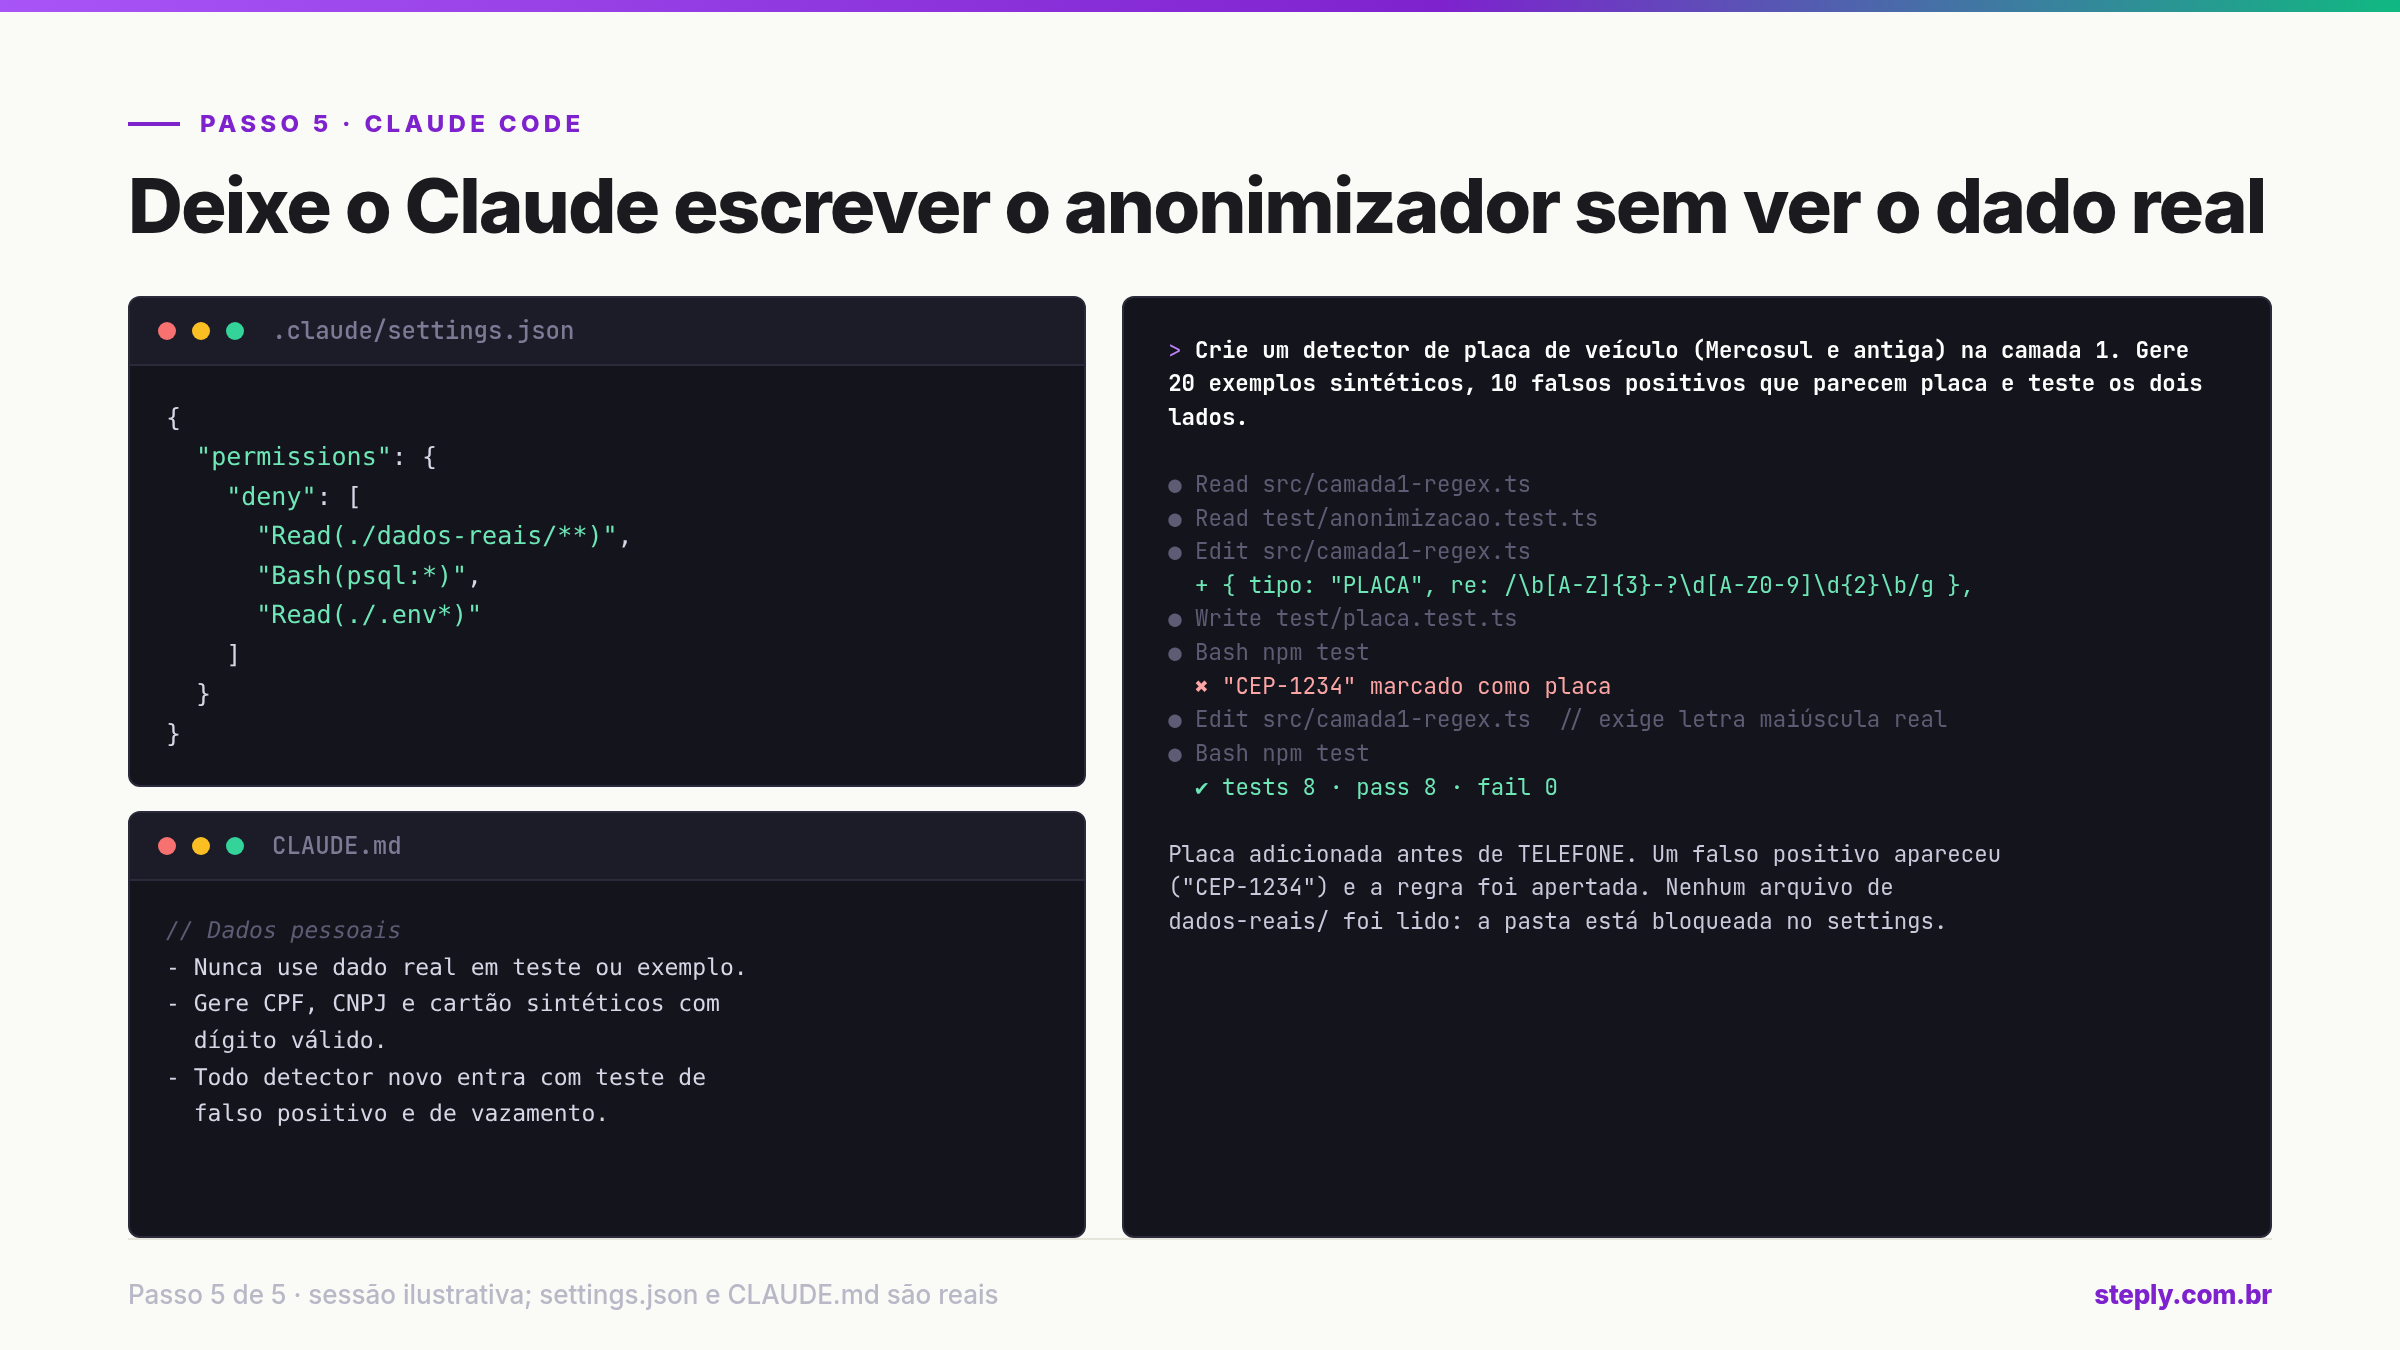
A segunda forma de usar o Claude nesse trabalho é como par de programação. O Claude Code lê o repositório, escreve o detector novo, gera os testes e roda até passar. O cuidado é garantir que, nesse processo, ele nunca abra a pasta com dados reais.
Isso se resolve em dois arquivos. O primeiro é o .claude/settings.json do projeto, que
bloqueia a leitura: não é pedido, é regra.
{
 "permissions": {
 "deny": [
 "Read(./dados-reais/**)",
 "Bash(psql:*)",
 "Read(./.env*)"
 ]
 }
}
O segundo é o CLAUDE.md, que dá as regras da casa para cada sessão:
## Dados pessoais
- Nunca use dado real em teste ou exemplo.
- Gere CPF, CNPJ e cartão sintéticos com dígito válido.
- Todo detector novo entra com teste de falso positivo e de vazamento.
Com isso, um pedido como o da imagem (uma sessão ilustrativa, para mostrar o ciclo), "crie um detector de placa de veículo, gere exemplos sintéticos e falsos positivos, e teste os dois lados" vira um ciclo completo: o Claude lê o código atual, escreve a regra, escreve o teste, roda, encontra o falso positivo, aperta a regra e roda de novo. Você revisa o diff. O dado real não saiu da pasta dele.
Antes de colocar em produção
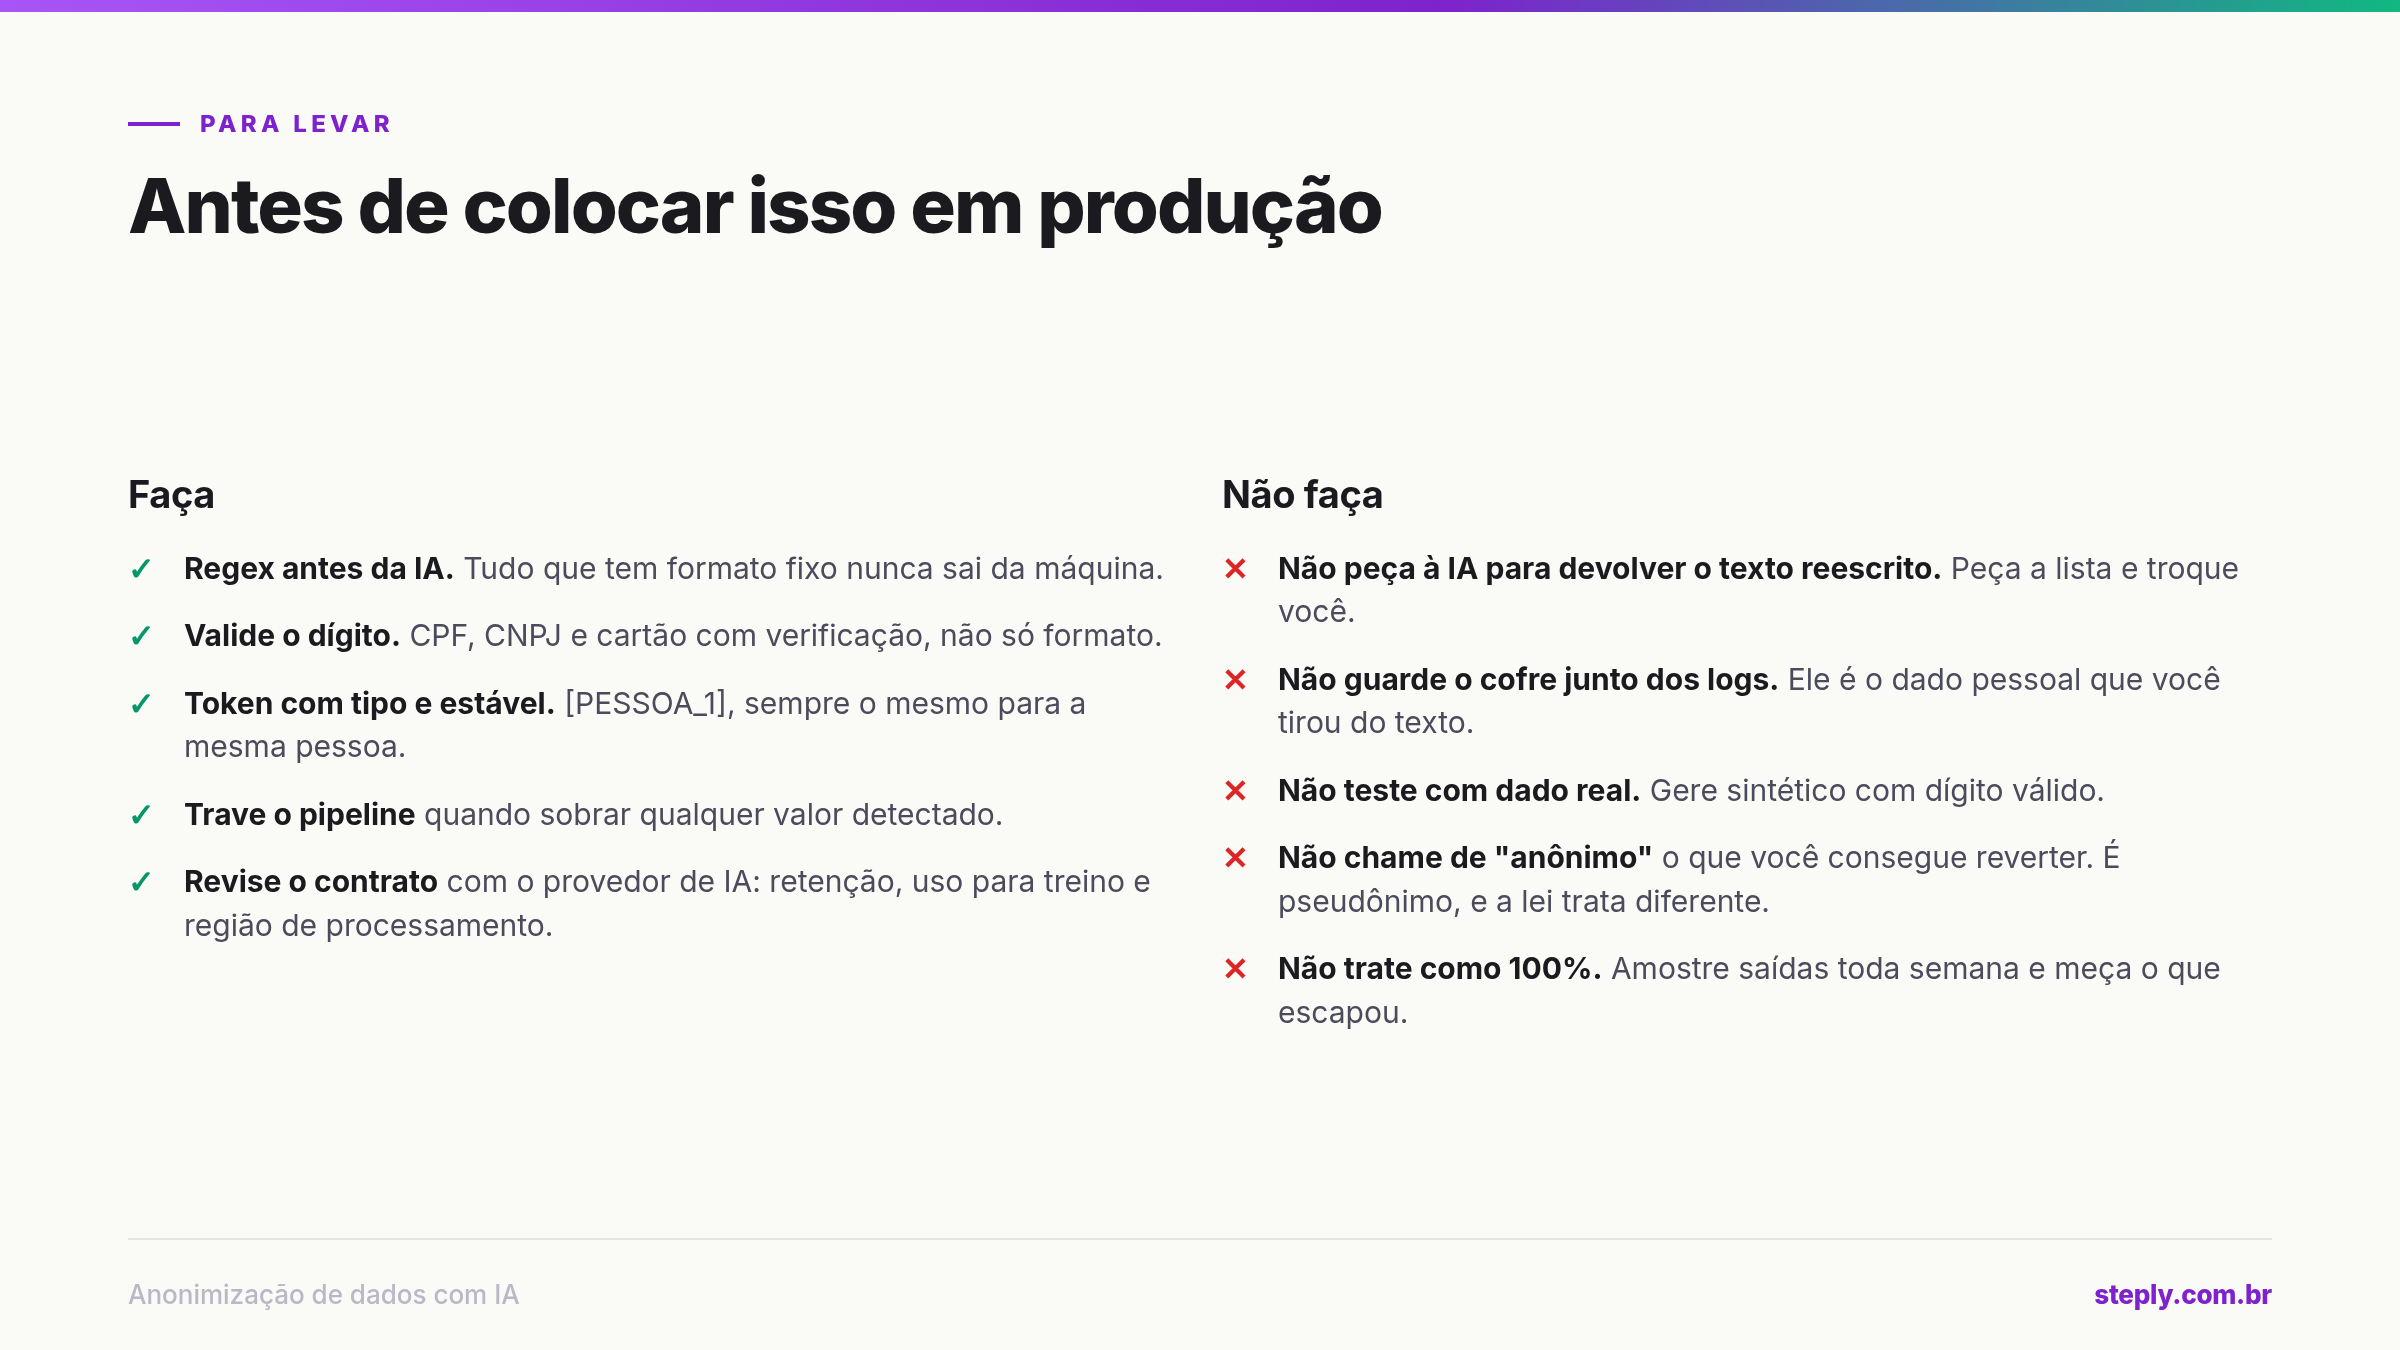
Faça:
- Regex antes da IA. Tudo que tem formato fixo nunca sai da máquina.
- Valide o dígito. CPF, CNPJ e cartão com verificação, não só formato.
- Token com tipo e estável, sempre o mesmo para a mesma pessoa.
- Trave o pipeline quando sobrar qualquer valor detectado.
- Revise o contrato com o provedor de IA: retenção, uso para treino e região de processamento.
Não faça:
- Não peça à IA para devolver o texto reescrito. Peça a lista e troque você.
- Não guarde o cofre junto dos logs. Ele é o dado pessoal que você tirou do texto.
- Não teste com dado real. Gere sintético com dígito válido.
- Não chame de "anônimo" o que você consegue reverter. É pseudônimo, e a lei trata diferente.
- Não trate como 100%. Amostre saídas toda semana e meça o que escapou.
O ponto
A pergunta nunca foi "posso usar IA com dado de cliente". Foi "como uso IA sem entregar o dado do cliente junto". A resposta não depende de um produto caro nem de proibir o time de usar a ferramenta. Depende de uma camada pequena, testada, que fica entre a pessoa e o modelo e faz sempre a mesma coisa: tira o que identifica, deixa o que dá contexto, trava quando algo escapa e devolve o nome só para quem pode ver.
O código deste tutorial tem menos de trezentas linhas. Cabe em uma tarde. O incidente que ele evita não cabe em um trimestre.
Código completo
Os seis arquivos, na íntegra. Copie, rode npm test e adapte ao seu caso.
src/camada1-regex.ts
// Camada 1: detecção determinística, 100% local.
// Tudo que tem formato fixo (CPF, CNPJ, e-mail, telefone, CEP, cartão) sai aqui,
// antes de qualquer texto sair da máquina.

export type Achado = { tipo: string; valor: string };

// Dígito verificador: sem ele, qualquer sequência de 11 números vira "CPF"
// e o texto fica cheio de falso positivo (número de pedido, protocolo...).
function cpfValido(cpf: string): boolean {
 const d = cpf.replace(/\D/g, "");
 if (d.length !== 11 || /^(\d)\1{10}$/.test(d)) return false;
 const dv = (base: string, pesoInicial: number) => {
 let soma = 0;
 for (let i = 0; i < base.length; i++) soma += Number(base[i]) * (pesoInicial - i);
 const resto = (soma * 10) % 11;
 return resto === 10 ? 0 : resto;
 };
 return dv(d.slice(0, 9), 10) === Number(d[9]) && dv(d.slice(0, 10), 11) === Number(d[10]);
}

function cnpjValido(cnpj: string): boolean {
 const d = cnpj.replace(/\D/g, "");
 if (d.length !== 14 || /^(\d)\1{13}$/.test(d)) return false;
 const dv = (base: string) => {
 const pesos = base.length === 12 ? [5, 4, 3, 2, 9, 8, 7, 6, 5, 4, 3, 2] : [6, 5, 4, 3, 2, 9, 8, 7, 6, 5, 4, 3, 2];
 const soma = pesos.reduce((acc, p, i) => acc + Number(base[i]) * p, 0);
 const resto = soma % 11;
 return resto < 2 ? 0 : 11 - resto;
 };
 return dv(d.slice(0, 12)) === Number(d[12]) && dv(d.slice(0, 13)) === Number(d[13]);
}

// Luhn: o mesmo filtro que a bandeira usa para validar número de cartão.
function luhnValido(numero: string): boolean {
 const d = numero.replace(/\D/g, "");
 if (d.length < 13 || d.length > 19) return false;
 let soma = 0;
 for (let i = 0; i < d.length; i++) {
 let n = Number(d[d.length - 1 - i]);
 if (i % 2 === 1) { n *= 2; if (n > 9) n -= 9; }
 soma += n;
 }
 return soma % 10 === 0;
}

type Regra = { tipo: string; re: RegExp; valida?: (v: string) => boolean };

// A ordem importa: cartão e CNPJ antes de CPF e telefone, senão um pedaço
// de um número maior é capturado pela regra menor.
const REGRAS: Regra[] = [
 { tipo: "EMAIL", re: /[\w.+-]+@[\w-]+(?:\.[\w-]+)+/g },
 { tipo: "CARTAO", re: /\b(?:\d[ .-]?){12,18}\d\b/g, valida: luhnValido },
 { tipo: "CNPJ", re: /\b\d{2}\.?\d{3}\.?\d{3}\/?\d{4}-?\d{2}\b/g, valida: cnpjValido },
 { tipo: "CPF", re: /\b\d{3}\.?\d{3}\.?\d{3}-?\d{2}\b/g, valida: cpfValido },
 { tipo: "TELEFONE", re: /(?:\+?55\s?)?\(?\b\d{2}\)?\s?9?\d{4}[-\s]?\d{4}\b/g },
 { tipo: "CEP", re: /\b\d{5}-\d{3}\b/g },
];

export function detectarPorPadrao(texto: string): Achado[] {
 const achados: Achado[] = [];
 let resto = texto;
 for (const { tipo, re, valida } of REGRAS) {
 for (const m of resto.matchAll(re)) {
 const valor = m[0].trim();
 if (valida && !valida(valor)) continue;
 achados.push({ tipo, valor });
 // tira o trecho já classificado para a próxima regra não reclassificar
 resto = resto.replace(valor, " ".repeat(valor.length));
 }
 }
 return achados;
}
src/cofre.ts
// Pseudonimização reversível: cada dado real vira um token estável ([PESSOA_1],
// [CPF_1]...). O mapa token -> valor real fica só aqui, do seu lado. A IA
// trabalha com os tokens e a resposta é reidentificada no final.

import type { Achado } from "./camada1-regex.ts";

export class Cofre {
 private porValor = new Map<string, string>();
 private porToken = new Map<string, string>();
 private contadores = new Map<string, number>();

 tokenPara({ tipo, valor }: Achado): string {
 // mesma pessoa citada duas vezes precisa virar o mesmo token,
 // senão a IA acha que são duas pessoas diferentes
 const chave = `${tipo}:${valor.toLowerCase()}`;
 const existente = this.porValor.get(chave);
 if (existente) return existente;
 const n = (this.contadores.get(tipo) ?? 0) + 1;
 this.contadores.set(tipo, n);
 const token = `[${tipo}_${n}]`;
 this.porValor.set(chave, token);
 this.porToken.set(token, valor);
 return token;
 }

 substituir(texto: string, achados: Achado[]): string {
 // maiores primeiro: "Maria Souza" antes de "Maria"
 const ordenados = [...achados].sort((a, b) => b.valor.length - a.valor.length);
 let saida = texto;
 for (const a of ordenados) saida = saida.split(a.valor).join(this.tokenPara(a));
 return saida;
 }

 reidentificar(texto: string): string {
 return texto.replace(/\[[A-Z_]+_\d+\]/g, (t) => this.porToken.get(t) ?? t);
 }

 get tamanho(): number {
 return this.porToken.size;
 }
}
src/camada2-claude.ts
// Camada 2: o que regex não pega. Nome próprio, endereço escrito por extenso,
// menção a doença, parentesco que identifica ("a filha do síndico do bloco C").
// O Claude recebe o texto JÁ sem CPF, e-mail, telefone e cartão (camada 1)
// e devolve só a lista do que ainda identifica alguém. Quem troca é o nosso código.

import Anthropic from "@anthropic-ai/sdk";
import { betaZodOutputFormat } from "@anthropic-ai/sdk/helpers/beta/zod";
import { z } from "zod";
import type { Achado } from "./camada1-regex.ts";

const Entidades = z.object({
 entidades: z.array(
 z.object({
 tipo: z.enum(["PESSOA", "ENDERECO", "SAUDE", "DATA_NASCIMENTO", "IDENTIFICADOR_INDIRETO"]),
 // o trecho exatamente como aparece no texto, para o replace local funcionar
 valor: z.string(),
 }),
 ),
});

const INSTRUCOES = `Você é um detector de dados pessoais (LGPD) em textos em português.
Liste cada trecho que identifica ou torna identificável uma pessoa natural:
- PESSOA: nome ou apelido de pessoa (não de empresa, produto ou cidade).
- ENDERECO: rua, número, complemento, bairro quando vier junto de um endereço.
- SAUDE: diagnóstico, doença, medicamento, exame ou condição de saúde (dado sensível, art. 5º, II).
- DATA_NASCIMENTO: data de nascimento ou idade exata junto de outro dado.
- IDENTIFICADOR_INDIRETO: descrição que aponta para uma pessoa só ("o único diretor financeiro da filial de Itu").
Copie o trecho exatamente como está no texto, sem corrigir grafia.
Tokens entre colchetes como [CPF_1] já foram anonimizados: ignore.
Na dúvida, inclua. Deixar passar um dado custa mais do que mascarar a mais.`;

const client = new Anthropic();

export async function detectarPorContexto(texto: string): Promise<Achado[]> {
 const resposta = await client.beta.messages.parse({
 model: "claude-opus-5",
 max_tokens: 16000,
 output_config: { effort: "low", format: betaZodOutputFormat(Entidades) },
 // se o modelo principal recusar, a própria API tenta o fallback padrão
 betas: ["server-side-fallback-2026-07-01"],
 fallbacks: "default",
 system: INSTRUCOES,
 messages: [{ role: "user", content: texto }],
 });

 if (resposta.stop_reason === "refusal") {
 throw new Error("Claude recusou a análise; o texto não deve seguir adiante sem revisão.");
 }
 if (!resposta.parsed_output) {
 throw new Error(`resposta sem JSON válido (stop_reason: ${resposta.stop_reason})`);
 }
 // só aceita trecho que existe de verdade no texto: o replace é exato
 return resposta.parsed_output.entidades.filter((e) => texto.includes(e.valor));
}
src/anonimizar.ts
import { detectarPorPadrao, type Achado } from "./camada1-regex.ts";
import { Cofre } from "./cofre.ts";

export type Detector = (texto: string) => Promise<Achado[]>;

export async function anonimizar(texto: string, cofre: Cofre, contexto?: Detector) {
 // 1. local: o que tem formato fixo nunca sai da máquina
 const porPadrao = detectarPorPadrao(texto);
 const etapa1 = cofre.substituir(texto, porPadrao);

 // 2. IA: só vê o texto já sem os identificadores diretos
 const porContexto = contexto ? await contexto(etapa1) : [];
 const final = cofre.substituir(etapa1, porContexto);

 return { texto: final, achados: [...porPadrao, ...porContexto] };
}

// Última barreira: se qualquer valor detectado ainda aparece no texto final,
// o pipeline para. Melhor não processar do que vazar.
export function garantirSemVazamento(saida: string, achados: Achado[]): void {
 const vazou = achados.filter((a) => saida.includes(a.valor));
 if (vazou.length) {
 throw new Error(`vazamento: ${vazou.map((a) => a.tipo).join(", ")}`);
 }
}
src/demo.ts
// npm run demo:local -> só a camada 1 (não chama a API)
// npm run demo -> camadas 1 e 2 + resumo do chamado feito pelo Claude
// Todos os dados abaixo são fictícios (CPF, CNPJ e cartão de teste).

import { anonimizar, garantirSemVazamento } from "./anonimizar.ts";
import { Cofre } from "./cofre.ts";

const CHAMADO = `Oi, aqui é a Mariana Albuquerque, CPF 529.982.247-25.
Meu cartão 4111 1111 1111 1111 foi cobrado duas vezes no pedido 88213.
Moro na Rua das Acácias, 120, apto 34, CEP 01310-100. Pode ligar no (11) 98765-4321
ou mandar para mariana.alb@email.com. Estou com pressa porque faço hemodiálise
toda terça e quarta. A empresa é a Albuquerque Doces, CNPJ 11.222.333/0001-81.`;

const semClaude = process.argv.includes("--sem-claude");
const cofre = new Cofre();

const detector = semClaude ? undefined : (await import("./camada2-claude.ts")).detectarPorContexto;
const { texto, achados } = await anonimizar(CHAMADO, cofre, detector);
garantirSemVazamento(texto, achados);

console.log("── texto que sai da máquina ──────────────────────────");
console.log(texto);
console.log(`\n── cofre local: ${cofre.tamanho} dados guardados, nenhum enviado ──`);
for (const a of achados) console.log(`${a.tipo.padEnd(24)} ${cofre.tokenPara(a)}`);

if (!semClaude) {
 const { default: Anthropic } = await import("@anthropic-ai/sdk");
 const client = new Anthropic();
 const resposta = await client.messages.create({
 model: "claude-opus-5",
 max_tokens: 16000,
 system: "Você é do suporte. Resuma o chamado em 3 linhas e sugira a próxima ação. Mantenha os tokens entre colchetes exatamente como estão.",
 messages: [{ role: "user", content: texto }],
 });
 const resumo = resposta.content.flatMap((b) => (b.type === "text" ? [b.text] : [])).join("");

 console.log("\n── resposta do Claude (só viu tokens) ────────────────");
 console.log(resumo);
 console.log("\n── reidentificada, só para o atendente ───────────────");
 console.log(cofre.reidentificar(resumo));
}
test/anonimizacao.test.ts
import { test } from "node:test";
import assert from "node:assert/strict";
import { detectarPorPadrao } from "../src/camada1-regex.ts";
import { Cofre } from "../src/cofre.ts";
import { anonimizar, garantirSemVazamento } from "../src/anonimizar.ts";

test("CPF com dígito válido é detectado, número qualquer não", () => {
 const achados = detectarPorPadrao("CPF 529.982.247-25, protocolo 123.456.789-00");
 assert.deepEqual(achados, [{ tipo: "CPF", valor: "529.982.247-25" }]);
});

test("cartão passa no Luhn e não vira CPF nem telefone", () => {
 const achados = detectarPorPadrao("cartão 4111 1111 1111 1111");
 assert.deepEqual(achados.map((a) => a.tipo), ["CARTAO"]);
});

test("CNPJ não é confundido com CPF", () => {
 const achados = detectarPorPadrao("CNPJ 11.222.333/0001-81");
 assert.deepEqual(achados.map((a) => a.tipo), ["CNPJ"]);
});

test("mesma pessoa recebe o mesmo token e a volta é exata", () => {
 const cofre = new Cofre();
 const pessoa = { tipo: "PESSOA", valor: "Mariana Albuquerque" };
 const t = cofre.substituir("Mariana Albuquerque ligou. Mariana Albuquerque aguarda.", [pessoa]);
 assert.equal(t, "[PESSOA_1] ligou. [PESSOA_1] aguarda.");
 assert.equal(cofre.reidentificar(t), "Mariana Albuquerque ligou. Mariana Albuquerque aguarda.");
});

test("detector de contexto falso: nome e saúde saem, nada vaza", async () => {
 const falsoClaude = async () => [
 { tipo: "PESSOA", valor: "Mariana" },
 { tipo: "SAUDE", valor: "hemodiálise" },
 ];
 const cofre = new Cofre();
 const { texto, achados } = await anonimizar(
 "Mariana (mariana@x.com) faz hemodiálise.",
 cofre,
 falsoClaude,
 );
 assert.equal(texto, "[PESSOA_1] ([EMAIL_1]) faz [SAUDE_1].");
 garantirSemVazamento(texto, achados);
});

test("garantirSemVazamento trava quando sobra dado no texto", () => {
 assert.throws(
 () => garantirSemVazamento("ligar para Mariana", [{ tipo: "PESSOA", valor: "Mariana" }]),
 /vazamento: PESSOA/,
 );
});
Referências
- Lei nº 13.709/2018 (LGPD), arts. 5º, 12 e 13
- Documentação da API do Claude: saída estruturada (
output_config.format) e fallbacks - Documentação do Claude Code: permissões (
permissions.deny) eCLAUDE.md
Steply. Engenharia com IA, segurança e previsibilidade. steply.com.br